

Trong các hệ thống web và trí tuệ nhân tạo, việc tìm kiếm và lựa chọn phương án phù hợp giữa nhiều khả năng là yếu tố quan trọng ảnh hưởng đến chất lượng xử lý và kết quả đầu ra. Beam search được ứng dụng để tối ưu quá trình tìm kiếm, giúp hệ thống cân nhắc nhiều hướng đi tiềm năng thay vì chỉ tập trung vào một lựa chọn duy nhất. Vậy beam search là gì? hoạt động theo nguyên lý nào và được ứng dụng ra sao trong thực tế? Cùng tìm hiểu chi tiết qua bài viết dưới đây.
- Beam search là gì?
- Nguyên lý hoạt động của thuật toán beam search
- Các thành phần quan trọng trong beam search algorithm
- 4 biến thể phổ biến của thuật toán beam search
- So sánh beam search với các thuật toán tìm kiếm khác
- Đánh giá ưu nhược điểm của beam search
- Ứng dụng thực tế của beam search trong phát triển web và AI
- Một số câu hỏi thường gặp về thuật toán beam search
- 1. Beam search có phải là thuật toán AI không?
- 2. Beam width bao nhiêu là tối ưu? Có phải beam width càng lớn thì kết quả càng chính xác?
- 3. Beam search có đảm bảo tìm ra kết quả tối ưu toàn cục không?
- 4. Khi nào nên và không nên sử dụng thuật toán beam search?
- 5. Beam search có được sử dụng trong các mô hình ngôn ngữ lớn (LLM) không?
- 6. Có thể kết hợp beam search với thuật toán tìm kiếm khác không?
Beam search là gì?
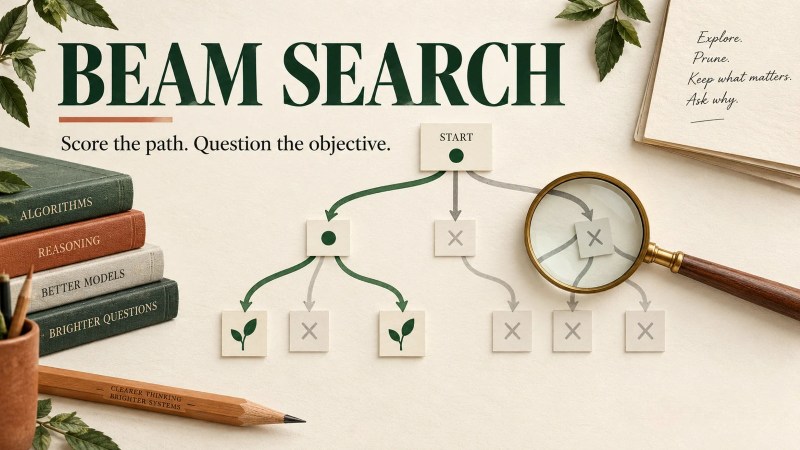
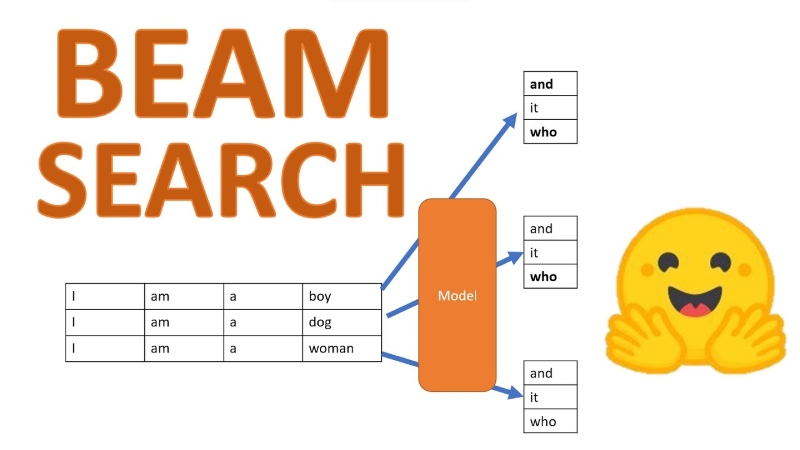
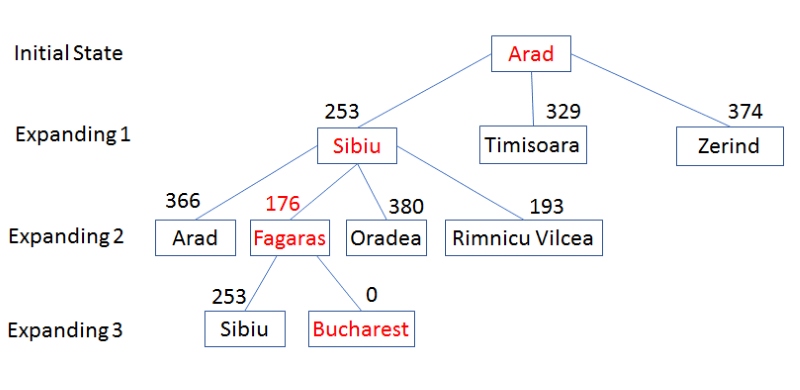
Beam search (tìm kiếm chùm) là thuật toán tìm kiếm heuristic dùng để khám phá không gian trạng thái bằng cách giữ lại một số lượng giới hạn các ứng viên tốt nhất tại mỗi bước mở rộng. Thay vì tiếp tục phát triển tất cả trạng thái có thể có, thuật toán chỉ giữ lại tối đa k ứng viên dựa trên điểm số do hàm đánh giá cung cấp. Giá trị k này được gọi là beam width (độ rộng tìm kiếm).
Beam search có thể được xem là một dạng tìm kiếm theo chiều rộng có giới hạn. Thuật toán mở rộng các trạng thái hiện tại, đánh giá những trạng thái mới và loại bỏ các ứng viên có điểm thấp hơn giới hạn cho phép. Cách làm này giúp giảm số lượng nhánh cần khám phá, từ đó tiết kiệm tài nguyên so với những phương pháp tìm kiếm rộng hơn.
Nguyên lý hoạt động của thuật toán beam search
Beam search hoạt động theo cơ chế tìm kiếm từng bước, trong đó mỗi vòng lặp đều mở rộng các ứng viên hiện có, đánh giá kết quả mới và giữ lại những ứng viên phù hợp nhất. Quy trình này tiếp tục cho đến khi tìm được kết quả đáp ứng yêu cầu hoặc đạt điều kiện dừng đã xác định.
1. Khởi tạo trạng thái tìm kiếm ban đầu
Đầu tiên, thuật toán xác định trạng thái bắt đầu của bài toán và đưa trạng thái đó vào tập ứng viên hiện tại. Tùy vào mục tiêu tìm kiếm, trạng thái ban đầu có thể là một nút trong đồ thị, một cấu hình của bài toán hoặc một chuỗi văn bản rỗng khi mô hình bắt đầu tạo câu.
Ở bước này, thuật toán cũng cần xác định beam width và hàm đánh giá để biết sẽ giữ lại bao nhiêu ứng viên và dựa vào tiêu chí nào để xếp hạng chúng. Ví dụ, nếu beam width bằng 3, tập tìm kiếm ban đầu có thể chỉ chứa một trạng thái, nhưng số lượng ứng viên được giữ lại sau khi mở rộng sẽ không vượt quá 3.
2. Mở rộng các trạng thái và tạo ứng viên mới
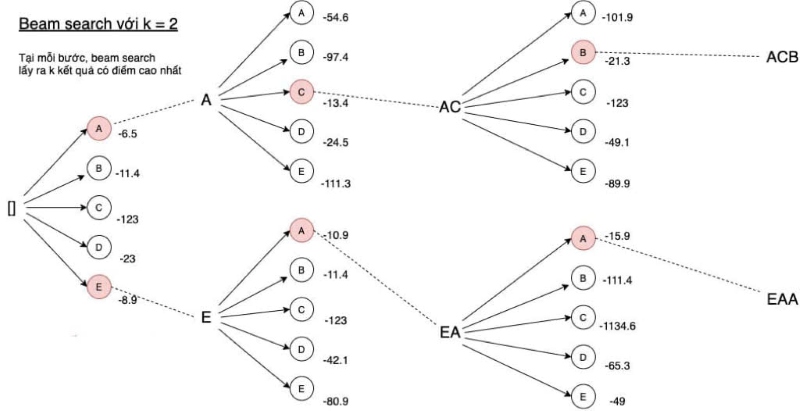
Sau khi khởi tạo, thuật toán beam search lần lượt mở rộng các trạng thái đang được giữ lại để tạo ra những trạng thái kế tiếp. Trong bài toán tạo văn bản, mỗi trạng thái có thể được biểu diễn bằng một chuỗi token, trong đó quá trình mở rộng là thêm một token mới vào cuối chuỗi để hình thành các phương án tiếp theo.
Ví dụ, nếu thuật toán đang giữ lại ba chuỗi ứng viên và mỗi chuỗi có thể được mở rộng bằng năm token khác nhau, hệ thống có thể tạo ra tối đa 15 ứng viên mới trong một bước tìm kiếm. Các ứng viên này sẽ được đưa vào danh sách để đánh giá và lựa chọn ở bước tiếp theo. Tuy nhiên, số lượng ứng viên thực tế còn phụ thuộc vào số lựa chọn hợp lệ tại mỗi trạng thái. Với những bài toán có ràng buộc cụ thể, thuật toán có thể loại bỏ ngay các trạng thái không đáp ứng yêu cầu nhằm hạn chế việc xử lý những phương án không khả thi.
3. Đánh giá và lựa chọn các ứng viên tốt nhất
Sau khi tạo tập ứng viên mới, thuật toán sử dụng hàm tính điểm để đánh giá và xếp hạng từng ứng viên dựa trên tiêu chí của bài toán, chẳng hạn như xác suất, chi phí đường đi hoặc điểm heuristic. Từ kết quả đánh giá, thuật toán giữ lại tối đa k ứng viên tốt nhất để tiếp tục mở rộng. Cụ thể, với bài toán tối đa hóa điểm số, thuật toán ưu tiên các ứng viên có điểm cao, ngược lại, với bài toán tối thiểu hóa chi phí, thuật toán chọn các ứng viên có chi phí thấp.
Tuy nhiên, việc lựa chọn chỉ dựa trên điểm đánh giá tại thời điểm hiện tại. Vì vậy, một ứng viên có tiềm năng đạt kết quả tốt hơn ở các bước tiếp theo vẫn có thể bị loại nếu điểm số ban đầu không đủ cao. Đây là hạn chế khiến beam search algorithm không bảo đảm tìm được nghiệm tối ưu toàn cục.
4. Lặp lại quá trình cho đến khi đạt điều kiện dừng
Sau mỗi vòng đánh giá, các ứng viên được giữ lại sẽ tiếp tục được mở rộng, tính điểm và chọn lọc trong vòng tiếp theo. Quá trình này lặp lại cho đến khi đáp ứng điều kiện dừng đã xác định. Tùy vào bài toán, thuật toán có thể dừng khi tìm thấy trạng thái đích, tạo ra token kết thúc trong mô hình ngôn ngữ, đạt giới hạn độ dài hoặc số bước, vượt quá thời gian xử lý cho phép hay không còn ứng viên hợp lệ để mở rộng. Với các bài toán sinh chuỗi, thuật toán cũng có thể kết thúc khi tất cả ứng viên được giữ lại đã hoàn thành.
Khi quá trình tìm kiếm kết thúc, hệ thống chọn kết quả đầu ra dựa trên tiêu chí đánh giá của bài toán. Nếu không tìm được ứng viên đáp ứng đầy đủ yêu cầu, hệ thống có thể trả về phương án tốt nhất trong số các ứng viên còn lại hoặc thông báo không tìm thấy kết quả hợp lệ, tùy theo cách triển khai.
5. Ví dụ minh họa cách hoạt động của beam search
Khi làm website, bạn muốn thiết kế một quy trình đăng ký gồm 3 bước sao cho người dùng cảm thấy tiện lợi nhất và không bỏ dở giữa chừng (đạt điểm chuyển đổi cao nhất trên thang điểm 100). Tại mỗi bước, hệ thống chỉ giữ lại 2 nhánh điểm cao nhất:
Bước 1: Chọn cách đăng ký ban đầu
- Google (80 điểm) -> Giữ lại
- Email (70 điểm) -> Giữ lại
- Số điện thoại (50 điểm) -> Loại bỏ
Bước 2: Ghép loại Form thu thập thông tin
Thử ghép 2 loại form (Khảo sát dài vs Form rút gọn) vào 2 nhánh đã giữ ở Bước 1:
- Google + Khảo sát dài: 65 điểm
- Google + Form rút gọn: 88 điểm -> Giữ lại
- Email + Khảo sát dài: 55 điểm
- Email + Form rút gọn: 85 điểm -> Giữ lại
Bước 3: Ghép trải nghiệm kết thúc
Thử ghép 2 lựa chọn (Xác minh mã với vào dùng ngay) vào 2 nhánh ở Bước 2:
- Google + Form rút gọn + Bắt xác minh lại: 78 điểm
- Google + Form rút gọn + Vào dùng ngay: 92 điểm
- Email + Form rút gọn + Bắt xác minh: 86 điểm
- Email + Form rút gọn + Vào dùng ngay: 95 điểm -> Phương án chiến thắng
Bản chất của beam search qua ví dụ trên:
- Lý do không dùng thuật toán Greedy Search (k=1): Nếu dùng Greedy, ở ngay Bước 1 hệ thống thấy nhánh Google (80 điểm) cao hơn nhánh Email (70 điểm) nên sẽ vứt bỏ nhánh Email ngay lập tức. Kết quả là Greedy sẽ chỉ tìm được phương án tốt nhất trong nhánh Google (tối đa 92 điểm) và bỏ lỡ hoàn toàn phương án "Email + Form rút gọn + Vào Dashboard ngay" (đạt tới 95 điểm).
- Lý do không dùng thuật toán vét cạn (Brute Force): Nếu luồng web có 10 bước và mỗi bước có 5 lựa chọn, thuật toán vét cạn sẽ phải tính toán tới 5^10 ≈ 9.7 triệu trường hợp, làm treo hệ thống.
- Giá trị cốt lõi của Beam Search: Bằng cách duy trì chùm tia k=2, thuật toán vừa cho nhánh Email một cơ hội lội ngược dòng ở các bước sau, vừa cắt bỏ sớm những nhánh kém tiềm năng để đảm bảo tốc độ phản hồi tính bằng mili-giây.
Các thành phần quan trọng trong beam search algorithm
Hiệu quả của beam search algorithm phụ thuộc vào cách thiết lập độ rộng tìm kiếm, phương pháp chấm điểm, phạm vi trạng thái có thể khám phá và điều kiện kết thúc. Hiểu rõ từng thành phần giúp người phát triển lựa chọn cấu hình phù hợp với yêu cầu về chất lượng đầu ra, tốc độ và tài nguyên xử lý.
1. Beam width (độ rộng tìm kiếm)
Beam width là số lượng ứng viên tối đa mà thuật toán giữ lại sau mỗi vòng chọn lọc. Đây là tham số quan trọng nhất vì nó ảnh hưởng trực tiếp đến phạm vi khám phá, thời gian xử lý và khả năng tìm được kết quả phù hợp. Khi beam width bằng 1, beam search gần như trở thành greedy search nếu sử dụng cùng cách mở rộng và chấm điểm.
Khi độ rộng tăng, thuật toán có thể duy trì nhiều hướng tìm kiếm hơn, qua đó giảm nguy cơ loại bỏ sớm một phương án tiềm năng. Tuy nhiên, beam width lớn cũng khiến hệ thống phải đánh giá nhiều ứng viên hơn, làm tăng mức tiêu thụ bộ nhớ và thời gian tính toán. Độ rộng lớn không đảm bảo kết quả tối ưu toàn cục vì các ứng viên tốt vẫn có thể bị loại do giới hạn của hàm tính điểm hoặc cơ chế cắt tỉa.
2. Scoring function (hàm tính điểm)
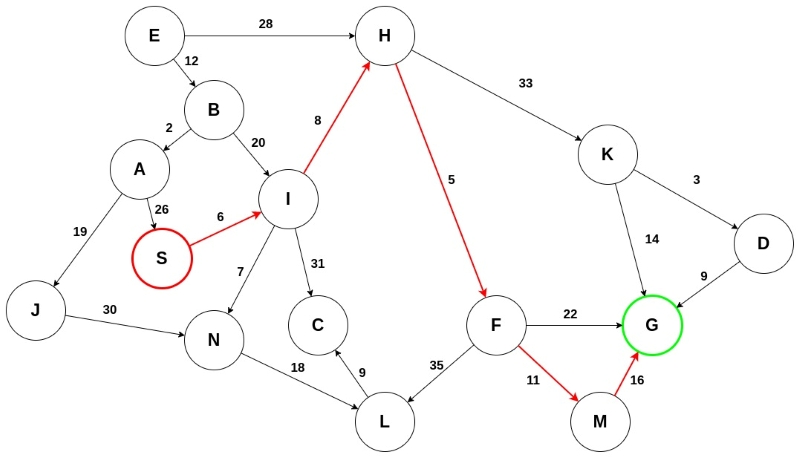
Scoring function à thành phần dùng để đánh giá và xếp hạng các ứng viên trong quá trình tìm kiếm của beam search algorithm, từ đó quyết định phương án nào được giữ lại để tiếp tục mở rộng. Cách tính điểm phụ thuộc vào mục tiêu của bài toán. Chẳng hạn, trong mô hình sinh ngôn ngữ, hệ thống có thể dựa vào xác suất của token tiếp theo dựa trên chuỗi đã có, còn trong bài toán tìm đường, hàm đánh giá có thể xem xét chi phí di chuyển và khoảng cách đến đích.
Để đạt kết quả phù hợp, hàm tính điểm cần phản ánh đúng mục tiêu của bài toán, nếu tiêu chí đánh giá chưa phù hợp, thuật toán có thể ưu tiên những ứng viên có điểm cao nhưng chất lượng thực tế thấp. Ngoài ra, với các chuỗi văn bản có độ dài khác nhau, việc cộng log-xác suất của từng token có thể khiến chuỗi dài bị bất lợi do tích lũy nhiều giá trị log-xác suất âm. Vì vậy, một số hệ thống sử dụng kỹ thuật chuẩn hóa độ dài hoặc điều chỉnh điểm số nhằm hạn chế thiên lệch này và giúp việc so sánh giữa các ứng viên hợp lý hơn.
3. Search space (không gian tìm kiếm)
Search space là tập hợp tất cả trạng thái hoặc phương án mà thuật toán có thể xem xét để tìm ra kết quả phù hợp. Quy mô của không gian tìm kiếm phụ thuộc vào đặc điểm bài toán, số lựa chọn ở mỗi bước và các ràng buộc được áp dụng. Chẳng hạn, trong mô hình ngôn ngữ, mỗi token được chọn có thể tạo ra nhiều chuỗi tiếp theo, khiến số phương án tăng nhanh khi độ dài văn bản tăng lên.
Beam search algorithm giúp kiểm soát quá trình tìm kiếm bằng cách chỉ giữ lại một số lượng ứng viên giới hạn sau mỗi vòng, thay vì tiếp tục mở rộng tất cả phương án có thể có. Điều này giúp giảm khối lượng tính toán, nhưng không làm thay đổi toàn bộ không gian tìm kiếm tiềm năng. Để tăng hiệu quả, nhà phát triển có thể kết hợp thuật toán với các ràng buộc đầu ra, cơ chế loại bỏ trạng thái trùng lặp hoặc giới hạn độ dài chuỗi, qua đó hạn chế việc xử lý những phương án không cần thiết.
4. Stopping criteria (điều kiện dừng)
Stopping criteria xác định thời điểm thuật toán kết thúc quá trình tìm kiếm. Nếu không có điều kiện dừng phù hợp, hệ thống có thể tiếp tục mở rộng trạng thái không cần thiết, làm tăng thời gian xử lý và tiêu tốn tài nguyên. Một số điều kiện dừng thường gặp gồm:
- Đạt trạng thái đích hoặc tạo được kết quả đáp ứng yêu cầu.
- Sinh ra token kết thúc trong bài toán tạo văn bản.
- Đạt giới hạn độ dài, số bước hoặc số lần mở rộng.
- Không còn ứng viên hợp lệ để tiếp tục.
- Đạt giới hạn thời gian hoặc ngân sách tính toán.
Trong thực tế, hệ thống có thể kết hợp nhiều điều kiện dừng để kiểm soát quá trình tìm kiếm. Ví dụ, mô hình sinh văn bản có thể dừng khi tạo ra token kết thúc, nhưng vẫn phải tuân thủ giới hạn số token tối đa nhằm tránh đầu ra quá dài.
4 biến thể phổ biến của thuật toán beam search
Beam search algorithm có nhiều biến thể nhằm khắc phục hạn chế của cách tìm kiếm tiêu chuẩn hoặc đáp ứng những yêu cầu cụ thể. Một số biến thể tập trung tăng tính đa dạng của kết quả, trong khi những biến thể khác đưa yếu tố ngẫu nhiên hoặc ràng buộc vào quá trình lựa chọn.
1. Standard beam search
Standard beam search là phiên bản cơ bản của thuật toán. Ở mỗi bước, hệ thống mở rộng các ứng viên hiện có, chấm điểm toàn bộ ứng viên mới và giữ lại những phương án có điểm cao nhất theo beam width.
Ưu điểm của phiên bản này là cách triển khai tương đối đơn giản, dễ kiểm soát số lượng ứng viên và phù hợp với nhiều bài toán sinh chuỗi. Tuy nhiên, thuật toán thường ưu tiên các ứng viên có điểm cao theo cùng một tiêu chí, vì vậy kết quả có thể thiếu đa dạng. Trong sinh văn bản, nhiều ứng viên được giữ lại đôi khi chỉ khác nhau ở một vài từ nhưng có nội dung gần như giống nhau.
2. Diverse beam search
Diverse beam search được thiết kế để tăng sự đa dạng giữa các kết quả được giữ lại. Thay vì chỉ xếp hạng từng ứng viên một cách độc lập, biến thể này có thể chia các ứng viên thành nhiều nhóm và bổ sung hình phạt hoặc tiêu chí nhằm hạn chế những lựa chọn quá giống nhau.
Phương pháp này hữu ích khi hệ thống cần tạo ra nhiều phương án khác biệt, chẳng hạn như sinh nhiều câu mô tả hình ảnh, đề xuất tiêu đề hoặc tạo các cách diễn đạt khác nhau cho cùng một nội dung.
Dù vậy, tăng tính đa dạng có thể khiến một số ứng viên có điểm xác suất thấp hơn được giữ lại. Vì thế, hệ thống cần cân bằng giữa độ đa dạng và mức độ phù hợp với mục tiêu đầu ra.
3. Stochastic beam search
Stochastic beam search đưa yếu tố ngẫu nhiên vào quá trình lựa chọn ứng viên, thay vì luôn giữ lại những phương án có điểm cao nhất theo một thứ tự cố định. Tùy cách triển khai, thuật toán có thể sử dụng cơ chế lấy mẫu có trọng số hoặc các phương pháp lấy mẫu không hoàn lại để lựa chọn một nhóm ứng viên.
Biến thể này giúp hệ thống khám phá những hướng phát triển khác nhau giữa các lần chạy, từ đó tạo ra kết quả đa dạng hơn. Cách tiếp cận này có thể phù hợp với các bài toán sinh nội dung cần nhiều phương án thay thế. Cần lưu ý rằng, kết quả có thể kém ổn định hơn so với tìm kiếm hoàn toàn xác định. Chất lượng đầu ra còn phụ thuộc vào phân phối lấy mẫu, cách tính điểm và các tham số được sử dụng.
4. Constrained beam search
Constrained beam search là biến thể của thuật toán beam search, bổ sung các ràng buộc vào quá trình tìm kiếm nhằm bảo đảm kết quả đáp ứng những điều kiện đã xác định. Các ràng buộc có thể yêu cầu đầu ra chứa từ khóa cụ thể, tuân thủ một cấu trúc nhất định hoặc tránh sử dụng những chuỗi token bị cấm.
Ví dụ, khi tạo nội dung cho biểu mẫu trên website, hệ thống có thể được yêu cầu đưa tên sản phẩm vào câu trả lời hoặc tuân thủ định dạng quy định. Khi đó, thuật toán sẽ tìm kiếm các ứng viên đáp ứng những điều kiện này, thay vì chỉ lựa chọn dựa trên điểm số thông thường. Tuy nhiên, nếu ràng buộc quá chặt hoặc không có phương án nào thỏa mãn, hệ thống có thể không tạo được kết quả hợp lệ. Vì vậy, cần xác định rõ các điều kiện bắt buộc và mức độ linh hoạt của từng ràng buộc.
So sánh beam search với các thuật toán tìm kiếm khác
Khi ứng dụng các thuật toán giải quyết bài toán trong phát triển web, từ việc tự động dựng bố cục, cá nhân hóa luồng trải nghiệm cho đến tối ưu hóa gói tài nguyên, thách thức lớn nhất của lập trình viên luôn là: đạt chất lượng giao diện tối ưu nhưng phải giữ độ trễ phản hồi ở mức mili-giây. Nếu chọn giải thuật quá vội vã, hệ thống rất dễ tạo ra một trải nghiệm người dùng chắp vá. Ngược lại, nếu dùng thuật toán vét cạn toàn bộ trường hợp, trình duyệt sẽ bị giật lag và máy chủ sẽ cạn kiệt tài nguyên xử lý.
Để thấy vì sao Beam Search được xem là giải pháp cân bằng lý tưởng cho môi trường web và AI hiện đại, hãy cùng đặt thuật toán này lên bàn cân so sánh với các phương pháp tìm kiếm phổ biến khác.
| Tiêu chí | Beam Search | Greedy Search | Breadth-First Search (BFS) | A* Search |
| Cách hoạt động | Giữ lại một số ứng viên tốt nhất ở mỗi bước | Chọn một ứng viên tốt nhất theo tiêu chí hiện tại | Mở rộng các nút theo từng mức | Ưu tiên nút theo tổng chi phí đã đi và chi phí ước tính còn lại |
| Phạm vi tìm kiếm | Giới hạn bằng beam width | Thường chỉ theo một nhánh | Mở rộng toàn bộ các nút trong từng mức | Phụ thuộc hàm đánh giá và cách triển khai |
| Bộ nhớ | Thường thấp hơn tìm kiếm toàn diện, nhưng tăng theo beam width | Thường thấp | Có thể rất lớn | Có thể lớn do phải lưu các nút chờ và đã xét |
| Khả năng tìm tối ưu toàn cục | Không bảo đảm | Không bảo đảm | Tìm đường đi ít cạnh nhất trong đồ thị không trọng số nếu xử lý đúng | Có thể bảo đảm tối ưu nếu đáp ứng các điều kiện về chi phí và heuristic |
Đánh giá ưu nhược điểm của beam search
Beam search được ứng dụng trong nhiều bài toán nhờ khả năng kiểm soát chi phí tìm kiếm và duy trì nhiều ứng viên tiềm năng cùng lúc. Cơ chế này giúp cân bằng giữa hiệu suất xử lý và chất lượng kết quả, đồng thời vẫn tồn tại một số hạn chế do việc loại bỏ các nhánh có điểm đánh giá thấp. Việc hiểu rõ ưu điểm và nhược điểm của thuật toán sẽ giúp người phát triển lựa chọn và áp dụng phù hợp với từng bài toán cụ thể.
1. Ưu điểm nổi bật của beam search
- Giảm chi phí tìm kiếm so với việc mở rộng toàn bộ ứng viên: Beam search chỉ giữ lại số lượng ứng viên giới hạn sau mỗi vòng, nhờ đó hạn chế số trạng thái cần tiếp tục xử lý. Lợi ích này đặc biệt rõ khi không gian tìm kiếm tăng nhanh theo độ sâu.
- Khám phá nhiều phương án thay vì chỉ chọn một hướng: Khác với greedy search, beam search duy trì nhiều ứng viên cùng lúc. Cách tiếp cận này giúp giảm nguy cơ phụ thuộc hoàn toàn vào một lựa chọn cục bộ ở bước đầu.
- Điều chỉnh được mức độ tìm kiếm: Nhà phát triển có thể thay đổi beam width để cân bằng giữa chất lượng đầu ra và chi phí tính toán. Beam width nhỏ phù hợp với yêu cầu phản hồi nhanh, còn beam width lớn có thể hữu ích khi chất lượng kết quả được ưu tiên hơn.
- Dễ kết hợp với các cơ chế đánh giá khác: Beam search có thể sử dụng hàm chấm điểm riêng, chuẩn hóa theo độ dài, ràng buộc đầu ra hoặc cơ chế khuyến khích tính đa dạng. Nhờ vậy, thuật toán có thể được điều chỉnh theo đặc điểm của từng ứng dụng.
2. Nhược điểm của beam search và cách khắc phục
Mặc dù có nhiều ưu điểm, beam search vẫn có thể đưa ra kết quả chưa tối ưu hoặc sử dụng nhiều tài nguyên nếu cấu hình không phù hợp. Một số hạn chế thường gặp và cách khắc phục gồm:
- Không bảo đảm tìm được kết quả tối ưu toàn cục: Beam search chỉ giữ lại những ứng viên có điểm đánh giá cao sau mỗi vòng và loại bỏ các phương án còn lại. Vì vậy, thuật toán có thể bỏ lỡ một ứng viên ban đầu có điểm thấp nhưng lại dẫn đến kết quả tốt hơn ở những bước tiếp theo. Để khắc phục, bạn tăng beam width khi tài nguyên cho phép, cải thiện hàm chấm điểm hoặc kết hợp với thuật toán khác nếu bài toán yêu cầu bảo đảm tối ưu.
- Các ứng viên có thể quá giống nhau: Nhiều ứng viên có điểm số cao có thể xuất phát từ những nhánh tương tự nhau. Khi đó, chùm tìm kiếm chứa nhiều phương án gần trùng lặp, làm giảm khả năng khám phá các hướng khác biệt. Để khắc phục, bạn nên áp dụng diverse beam search, bổ sung cơ chế phạt sự tương đồng hoặc loại bỏ trạng thái trùng lặp khi phù hợp với bài toán.
- Chi phí tính toán vẫn có thể tăng cao: Beam width càng lớn thì thuật toán càng phải mở rộng và đánh giá nhiều ứng viên. Với mô hình ngôn ngữ có bộ từ vựng lớn hoặc chuỗi đầu ra dài, chi phí tính toán có thể tăng đáng kể. Để khắc phục, bạn nên giới hạn độ dài đầu ra, tối ưu việc tính điểm, sử dụng bộ nhớ đệm khi có thể và thử nghiệm nhiều mức beam width để tìm cấu hình phù hợp.
- Hàm chấm điểm có thể không phản ánh đúng chất lượng thực tế: Một ứng viên có xác suất cao chưa chắc là câu trả lời chính xác, tự nhiên hoặc hữu ích nhất. Nếu hàm chấm điểm chỉ ưu tiên một tiêu chí, thuật toán có thể tạo ra đầu ra không đáp ứng đầy đủ mục tiêu. Để khắc phục, bạn hãy điều chỉnh hàm đánh giá, kiểm thử bằng dữ liệu thực tế và kết hợp các tiêu chí phù hợp. Với tác vụ tạo văn bản, cần đánh giá cả chất lượng ngôn ngữ lẫn mức độ đáp ứng yêu cầu, thay vì chỉ dựa vào điểm xác suất.
Ứng dụng thực tế của beam search trong phát triển web và AI
Beam search có thể được sử dụng trong nhiều hệ thống AI cần lựa chọn chuỗi hoặc phương án qua nhiều bước. Trong phát triển web, thuật toán thường không trực tiếp xây dựng giao diện mà được tích hợp vào mô hình hoặc dịch vụ phía sau để tạo kết quả cho các tính năng như chatbot, tìm kiếm ngôn ngữ tự nhiên và xử lý nội dung đa phương tiện.
1. Tính năng tìm kiếm thông minh
Trong một số hệ thống tìm kiếm, beam search có thể hỗ trợ tạo hoặc lựa chọn chuỗi truy vấn, giải mã kết quả từ mô hình ngôn ngữ hay khám phá các phương án phù hợp với đầu vào của người dùng. Ví dụ, một công cụ tìm kiếm ngữ nghĩa có thể sử dụng mô hình AI để diễn giải truy vấn và sinh ra các cách diễn đạt liên quan trước khi truy xuất dữ liệu.
Tuy nhiên, thuật toán beam search không phải thuật toán xếp hạng kết quả tìm kiếm phổ biến cho mọi công cụ tìm kiếm. Những hệ thống truy xuất tài liệu thường dựa vào chỉ mục, điểm tương đồng, mô hình xếp hạng hoặc kết hợp nhiều phương pháp. Beam Search chỉ phù hợp khi bài toán có cấu trúc tìm kiếm tuần tự hoặc cần giải mã nhiều bước.
2. Xử lý ngôn ngữ tự nhiên (NLP)
Trong xử lý ngôn ngữ tự nhiên, beam search NLP thường được sử dụng để giải mã đầu ra của mô hình khi cần tạo một chuỗi token. Các ứng dụng tiêu biểu gồm dịch máy, tóm tắt văn bản, sinh câu và một số bài toán gán nhãn hoặc dự đoán chuỗi.
Ví dụ, khi dịch một câu tiếng Việt sang tiếng Anh, hệ thống có thể cân nhắc nhiều từ và cụm từ tiếp theo thay vì chọn ngay phương án có xác suất cao nhất ở từng bước. Beam search giữ lại một số chuỗi ứng viên, sau đó tiếp tục mở rộng và đánh giá chúng để tìm bản dịch phù hợp hơn theo tiêu chí của mô hình.
Dù vậy, điểm xác suất cao không đồng nghĩa với bản dịch chính xác nhất về ngữ nghĩa. Chất lượng cuối cùng vẫn phụ thuộc vào mô hình, dữ liệu huấn luyện, hàm tính điểm và cách đánh giá kết quả.
3. Chatbot và AI tạo sinh
Trong chatbot và các hệ thống AI tạo sinh, beam search có thể được dùng để lựa chọn chuỗi phản hồi từ những khả năng do mô hình dự đoán. Thuật toán có thể duy trì nhiều cách diễn đạt trong quá trình giải mã rồi chọn kết quả có điểm số cao nhất theo tiêu chí đã thiết lập.
Phương pháp này phù hợp với một số tác vụ cần đầu ra ổn định, có cấu trúc hoặc ưu tiên một phương án theo điểm số của mô hình. Tuy nhiên, với hội thoại mở, câu trả lời có thể trở nên lặp lại hoặc thiếu tự nhiên nếu hệ thống chỉ ưu tiên những chuỗi có xác suất cao.
Vì vậy, nhiều hệ thống AI tạo sinh sử dụng các phương pháp giải mã khác, chẳng hạn như lấy mẫu theo xác suất, top-k hoặc top-p, tùy mục tiêu về tính đa dạng và độ ổn định. Beam search không phải phương pháp mặc định cho mọi mô hình ngôn ngữ lớn (LLM).
4. Xử lý âm thanh & video trực tiếp trên nền tảng web
Trong nhận dạng giọng nói, beam search NLP có thể giúp lựa chọn chuỗi từ phù hợp từ các khả năng mà mô hình âm thanh đưa ra. Hệ thống có thể giữ lại nhiều giả thuyết về nội dung lời nói, sau đó cập nhật điểm số và chọn chuỗi phù hợp hơn khi có thêm thông tin.
Đối với các ứng dụng web có tính năng phụ đề tự động, chuyển giọng nói thành văn bản hoặc điều khiển bằng giọng nói, thuật toán có thể được tích hợp vào mô hình nhận dạng phía máy chủ hoặc trong một quy trình xử lý tương thích trên thiết bị.
Với video, beam search có thể hỗ trợ một số tác vụ liên quan đến giải mã chuỗi, chẳng hạn như nhận dạng lời thoại hoặc tạo mô tả từ đầu ra của mô hình đa phương thức. Tuy nhiên, thuật toán không tự xử lý toàn bộ dữ liệu âm thanh và video, cũng không mặc nhiên làm tăng tốc độ xử lý thời gian thực. Độ trễ còn phụ thuộc vào mô hình, phần cứng, độ dài đầu vào và cách triển khai.
5. Tạo nội dung và mô tả hình ảnh
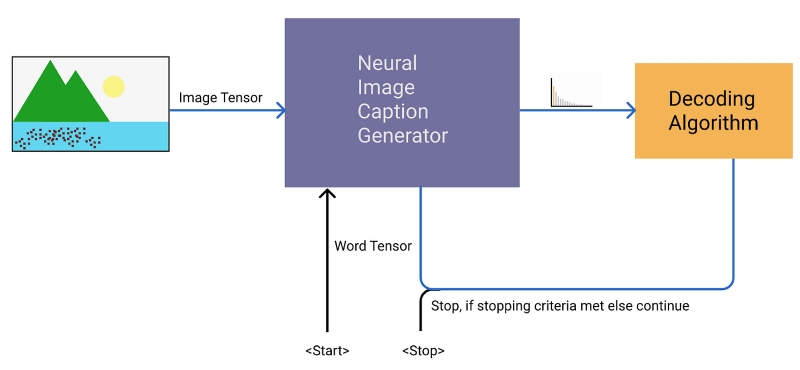
Beam search NLP có thể được ứng dụng trong các mô hình tạo mô tả hình ảnh (image captioning). Sau khi mô hình phân tích nội dung hình ảnh, thuật toán hỗ trợ lựa chọn chuỗi từ để hình thành câu mô tả tương ứng.
Ví dụ, với hình ảnh một chú chó đang chạy trên bãi cỏ, hệ thống có thể tạo nhiều chuỗi mô tả như “Một chú chó đang chạy trên cỏ” hoặc “Chú chó vui đùa ngoài sân”. Beam search đánh giá các chuỗi theo điểm số của mô hình và giữ lại những ứng viên phù hợp trong quá trình sinh câu.
Trong website thương mại điện tử, kỹ thuật này có thể hỗ trợ tạo mô tả sản phẩm hoặc nội dung thay thế cho hình ảnh khi được tích hợp vào một quy trình AI phù hợp. Tuy nhiên, hệ thống vẫn cần kiểm tra độ chính xác của nội dung, nhất là khi mô tả đặc điểm sản phẩm, chất liệu hoặc thông tin quan trọng mà hình ảnh không thể xác nhận đầy đủ.
6. Tính năng lập lịch & định tuyến
Trong các bài toán lập lịch hoặc định tuyến, beam search có thể được dùng để tìm kiếm những phương án khả thi trong không gian trạng thái lớn. Mỗi trạng thái có thể đại diện cho một lịch trình từng phần hoặc một tuyến đường đang được xây dựng. Thuật toán mở rộng các phương án, đánh giá chi phí và giữ lại những ứng viên có triển vọng.
Ví dụ, một hệ thống giao hàng có thể xây dựng nhiều tuyến đường dựa trên các điểm giao hàng, thời gian di chuyển và những điều kiện vận hành đã cho. Beam search giúp giới hạn số phương án cần tiếp tục xem xét, từ đó giảm bớt khối lượng tìm kiếm so với việc liệt kê mọi tuyến đường.
Tuy nhiên, thuật toán không bảo đảm tìm được lịch trình hoặc tuyến đường tối ưu toàn cục. Với bài toán có nhiều ràng buộc phức tạp, người phát triển cần thiết kế hàm đánh giá phù hợp và có thể kết hợp beam search NLP với các thuật toán tối ưu hóa khác.
Một số câu hỏi thường gặp về thuật toán beam search
Ngoài nguyên lý hoạt động, người học thường quan tâm đến cách chọn beam width, khả năng tìm nghiệm tối ưu và phạm vi ứng dụng của beam search trong các hệ thống AI hiện đại. Những câu trả lời dưới đây giúp làm rõ các vấn đề thường gặp khi tìm hiểu và triển khai thuật toán.
1. Beam search có phải là thuật toán AI không?
Beam search là một thuật toán tìm kiếm được sử dụng trong nhiều hệ thống AI, nhưng bản thân nó không phải mô hình AI. Thuật toán xác định cách khám phá và lựa chọn ứng viên trong không gian tìm kiếm dựa trên điểm số hoặc tiêu chí đánh giá.
Trong hệ thống AI, beam search thường kết hợp với một mô hình dự đoán để tìm chuỗi đầu ra. Chẳng hạn, mô hình ngôn ngữ dự đoán xác suất token, còn beam search sử dụng các điểm số đó để duy trì và lựa chọn những chuỗi ứng viên. Vì vậy, cần phân biệt thuật toán tìm kiếm với mô hình tạo ra dự đoán.
2. Beam width bao nhiêu là tối ưu? Có phải beam width càng lớn thì kết quả càng chính xác?
Không có giá trị beam width tối ưu cho mọi bài toán. Beam width lớn giúp giữ lại nhiều ứng viên hơn, nhưng đồng thời làm tăng chi phí tính toán và không đảm bảo kết quả chính xác hơn trong mọi trường hợp. Người triển khai nên thử nghiệm nhiều giá trị trên bộ dữ liệu đại diện, sau đó so sánh chất lượng đầu ra, thời gian xử lý và mức tiêu thụ tài nguyên để lựa chọn phù hợp.
3. Beam search có đảm bảo tìm ra kết quả tối ưu toàn cục không?
Không. Beam search có thể loại bỏ một ứng viên ngay từ bước đầu nếu điểm đánh giá của nó thấp, dù nhánh đó có khả năng dẫn đến kết quả tốt nhất về sau. Vì vậy, thuật toán thường được xếp vào nhóm tìm kiếm gần đúng có giới hạn. Muốn đảm bảo tối ưu toàn cục, cần lựa chọn thuật toán và điều kiện phù hợp với cấu trúc bài toán, thay vì chỉ dựa vào Beam Search tiêu chuẩn.
4. Khi nào nên và không nên sử dụng thuật toán beam search?
Thuật toán beam search phù hợp khi không gian tìm kiếm lớn, mỗi trạng thái có nhiều lựa chọn và hệ thống cần cân bằng giữa chất lượng kết quả với chi phí tính toán. Thuật toán thường hữu ích trong giải mã ngôn ngữ, dịch máy, nhận dạng giọng nói và một số bài toán lập kế hoạch.
Ngược lại, beam search có thể không phù hợp nếu bài toán cần đảm bảo tìm được nghiệm tối ưu, cần khám phá đầy đủ các trạng thái hoặc yêu cầu kết quả có tính đa dạng cao mà không có cơ chế điều chỉnh. Trong những trường hợp này, người phát triển nên cân nhắc BFS, DFS, A*, các phương pháp tối ưu chuyên biệt hoặc kết hợp nhiều kỹ thuật tìm kiếm.
5. Beam search có được sử dụng trong các mô hình ngôn ngữ lớn (LLM) không?
Có. Beam search có thể được dùng trong quá trình giải mã đầu ra của một số mô hình ngôn ngữ lớn, nhưng không phải tất cả LLM đều sử dụng phương pháp này làm mặc định. Tùy mục tiêu, hệ thống có thể chọn greedy decoding, beam search hoặc các phương pháp lấy mẫu như top-k và top-p. Với tác vụ cần câu trả lời đa dạng, lấy mẫu thường được ưu tiên hơn; với tác vụ cần đầu ra ổn định theo tiêu chí điểm số, Beam Search có thể là lựa chọn phù hợp.
6. Có thể kết hợp beam search với thuật toán tìm kiếm khác không?
Có. Beam search có thể kết hợp với heuristic, hàm đánh giá chuyên biệt, cơ chế kiểm tra ràng buộc hoặc các phương pháp tối ưu khác. Chẳng hạn, hệ thống có thể dùng beam search để tạo một tập phương án ứng viên rồi đánh giá lại bằng mô hình khác; hoặc dùng heuristic để sắp xếp, lọc các trạng thái trước khi mở rộng.
Việc kết hợp cần dựa trên đặc điểm bài toán và mục tiêu tối ưu. Một cơ chế bổ sung tốt có thể cải thiện chất lượng kết quả, nhưng cũng cần đánh giá chi phí tính toán và kiểm tra xem phương pháp mới có đáp ứng các yêu cầu về tính chính xác hay không.
Qua bài viết trên, Phương Nam Vina đã làm rõ khái niệm beam search, nguyên lý hoạt động, các biến thể phổ biến cũng như ưu nhược điểm và ứng dụng thực tế của thuật toán này. Việc lựa chọn beam width, hàm chấm điểm và điều kiện dừng phù hợp sẽ góp phần cân bằng giữa chất lượng kết quả và chi phí tính toán. Hy vọng những thông tin trên đã giúp bạn hiểu rõ hơn về thuật toán beam search và có cơ sở lựa chọn phương pháp tìm kiếm phù hợp khi phát triển các hệ thống AI.
Tham khảo thêm:
 PaaS là gì? Hiểu rõ sự khác biệt giữa PaaS, IaaS và SaaS
WebMCP là gì? Lợi ích, ứng dụng và cách triển khai WebMCP
Microcopy là gì? Vai trò và cách viết microcopy website hiệu quả