

Sự phát triển của AI đang thay đổi cách website xử lý ngôn ngữ và tương tác với người dùng. Thay vì phụ thuộc hoàn toàn vào từ khóa chính xác, các hệ thống hiện đại có thể phân tích ý định, ngữ nghĩa và mối quan hệ giữa các khái niệm trong một truy vấn. NLP (Natural language processing) đóng vai trò quan trọng trong quá trình này, đồng thời được sử dụng trong tìm kiếm thông minh, chatbot, hệ thống nội dung và nhiều tính năng website hiện đại. Vậy NLP là gì? Hoạt động như thế nào và được tích hợp vào website ra sao? Cùng tìm hiểu chi tiết trong bài viết dưới đây!
- NLP là gì?
- Vai trò của NLP trong xu hướng phát triển website hiện nay
- Mối liên hệ giữa AI, machine learning, deep learning và NLP
- NLP hoạt động như thế nào? Quy trình xử lý ngôn ngữ tự nhiên
- Các mô hình & kỹ thuật NLP phổ biến từ truyền thống đến hiện đại
- Ứng dụng của NLP trong phát triển website
- NLP trong SEO và thuật toán tìm kiếm của Google
- Quy trình tích hợp NLP vào website chi tiết, chuyên nghiệp
- Bước 1: Xác định mục tiêu bài toán & lựa chọn usecase
- Bước 2: Lựa chọn phương án kiến trúc & mô hình NLP
- Bước 3: Chuẩn bị & tiền xử lý dữ liệu nội bộ (data pipeline)
- Bước 4: Xây dựng backend API & lớp middleware
- Bước 5: Triển khai frontend UI/UX & tối ưu performance
- Bước 6: Kiểm thử & giám sát hệ thống
- Bước 7: Bảo trì, đào tạo liên tục
- Những thách thức lớn khi triển khai natural language processing
NLP là gì?
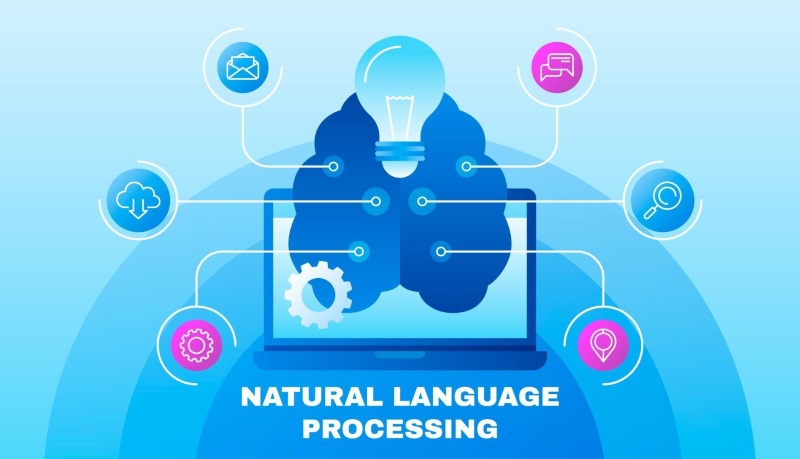
NLP (Natural language processing - xử lý ngôn ngữ tự nhiên) là một lĩnh vực thuộc trí tuệ nhân tạo (AI), tập trung vào khả năng giúp máy tính hiểu, phân tích và xử lý ngôn ngữ mà con người sử dụng trong giao tiếp hằng ngày. Thông qua NLP, hệ thống có thể tiếp nhận văn bản hoặc lời nói, xác định ý nghĩa, ngữ cảnh và mục đích của người dùng, sau đó đưa ra kết quả hoặc phản hồi phù hợp.
Natural language processing được ứng dụng trong nhiều công nghệ quen thuộc như công cụ tìm kiếm, chatbot, trợ lý ảo, dịch máy, tìm kiếm bằng giọng nói và hệ thống đề xuất nội dung. Chẳng hạn, khi người dùng nhập một câu hỏi tự nhiên vào chatbot trên website, NLP giúp hệ thống phân tích câu hỏi để xác định người dùng đang muốn biết điều gì thay vì chỉ nhận diện từng từ riêng lẻ.
Về cơ bản, natural language processing hoạt động dựa trên sự kết hợp giữa ngôn ngữ học, học máy (machine learning) và các mô hình AI. Nhờ khả năng xử lý lượng lớn dữ liệu ngôn ngữ, NLP giúp máy tính giao tiếp với con người theo cách tự nhiên hơn, đồng thời mở rộng khả năng tự động hóa và cá nhân hóa trong nhiều lĩnh vực.
Vai trò của NLP trong xu hướng phát triển website hiện nay
NLP đang trở thành một thành phần quan trọng trong quá trình phát triển website theo hướng thông minh, tự nhiên và lấy người dùng làm trung tâm. Thay vì chỉ xử lý dữ liệu dựa trên từ khóa hoặc các thao tác được lập trình sẵn, website có thể hiểu tốt hơn nội dung người dùng nhập vào, nhận diện ý định và đưa ra phản hồi phù hợp. Một số vai trò nổi bật của natural language processing gồm:
- Cải thiện khả năng tìm kiếm trên website: NLP giúp hệ thống hiểu được ý nghĩa và ý định phía sau truy vấn thay vì chỉ tìm những trang có chứa chính xác từ khóa người dùng nhập. Chẳng hạn, khi người dùng tìm “laptop cho dân văn phòng dưới 20 triệu”, website có thể nhận diện các yếu tố như nhu cầu sử dụng, nhóm sản phẩm và mức ngân sách để đưa ra kết quả phù hợp hơn. Cách xử lý này đặc biệt hữu ích với các website thương mại điện tử, tin tức, dịch vụ và có lượng nội dung lớn.
- Phát triển chatbot và trợ lý AI: NLP cho phép chatbot hiểu câu hỏi được diễn đạt bằng ngôn ngữ tự nhiên, kể cả khi người dùng viết không theo một cấu trúc cố định. Hệ thống có thể phân tích câu hỏi, xác định nhu cầu và phản hồi dựa trên dữ liệu được cung cấp. Nhờ đó, chatbot trên website có thể hỗ trợ tư vấn sản phẩm, giải đáp câu hỏi thường gặp, hướng dẫn sử dụng dịch vụ hoặc tiếp nhận thông tin khách hàng.
- Cá nhân hóa trải nghiệm người dùng: NLP có thể phân tích nội dung mà người dùng tìm kiếm, đọc hoặc tương tác để xác định chủ đề và nhu cầu quan tâm. Website từ đó có thể đề xuất bài viết, sản phẩm hoặc dịch vụ có liên quan thay vì hiển thị cùng một nội dung cho tất cả người dùng. Điều này giúp hành trình khám phá website trở nên phù hợp hơn với từng nhóm khách hàng.
- Tối ưu tìm kiếm bằng giọng nói: Khi người dùng chuyển từ việc nhập từ khóa ngắn sang đặt câu hỏi bằng giọng nói, website cần có khả năng hiểu những câu truy vấn gần với cách giao tiếp hằng ngày. Natural language processing hỗ trợ phân tích câu nói, xác định các thực thể và ý định tìm kiếm để hệ thống đưa ra câu trả lời hoặc kết quả phù hợp. Đây cũng là một trong những yếu tố thúc đẩy website phát triển theo hướng giao tiếp tự nhiên hơn với người dùng.
- Hỗ trợ xây dựng và tối ưu nội dung: NLP có thể phân tích một lượng lớn văn bản để xác định chủ đề, thuật ngữ liên quan, ngữ cảnh và mối quan hệ giữa các khái niệm. Dữ liệu này hỗ trợ người làm nội dung xây dựng bài viết có phạm vi chủ đề đầy đủ hơn, đồng thời cải thiện khả năng đáp ứng nhu cầu tìm kiếm của người dùng. NLP cũng có thể được sử dụng để phân loại nội dung, phát hiện chủ đề hoặc hỗ trợ tạo bản tóm tắt.
Mối liên hệ giữa AI, machine learning, deep learning và NLP
AI, machine learning, deep learning và natural language processing là những khái niệm có mối quan hệ chặt chẽ nhưng không đồng nghĩa với nhau. Có thể hình dung chúng theo mối quan hệ từ rộng đến hẹp: AI là lĩnh vực lớn, machine learning là một phương pháp giúp AI học từ dữ liệu, deep learning là một nhánh của machine learning, còn NLP là lĩnh vực tập trung vào việc giúp máy tính hiểu và xử lý ngôn ngữ của con người.
- AI (Artificial Intelligence): Là khái niệm rộng nhất, đề cập đến khả năng của máy móc thực hiện những nhiệm vụ thường cần đến trí thông minh của con người như nhận diện hình ảnh, suy luận, ra quyết định, hiểu ngôn ngữ hoặc tạo nội dung.
- Machine learning (học máy): Là một nhánh của AI, trong đó hệ thống được huấn luyện bằng dữ liệu để nhận diện quy luật và đưa ra dự đoán hoặc quyết định thay vì phải lập trình thủ công cho từng trường hợp. Trong NLP, machine learning có thể được sử dụng để phân loại văn bản, nhận diện ý định của người dùng hoặc phân tích cảm xúc trong câu.
- Deep learning (học sâu): Là một nhánh của machine learning, sử dụng các mạng nơ-ron nhân tạo có nhiều lớp để học những mối quan hệ phức tạp trong dữ liệu. Deep learning đã thúc đẩy mạnh mẽ sự phát triển của NLP nhờ khả năng xử lý lượng lớn dữ liệu văn bản và ngôn ngữ, đặc biệt trong các mô hình ngôn ngữ hiện đại.
- NLP (Natural Language Processing - xử lý ngôn ngữ tự nhiên): Là lĩnh vực tập trung vào việc giúp máy tính hiểu, phân tích, xử lý và tạo ra ngôn ngữ của con người. NLP có thể sử dụng nhiều phương pháp khác nhau, trong đó machine learning và deep learning là những phương pháp quan trọng để xây dựng các hệ thống hiểu ngôn ngữ.
Nói cách khác, NLP không phải là một cấp độ nằm bên trong deep learning. Natural language processing là một lĩnh vực ứng dụng, còn machine learning và deep learning là những phương pháp có thể được sử dụng để giải quyết các bài toán NLP. Chẳng hạn, chatbot AI có thể sử dụng NLP để hiểu câu hỏi của người dùng, deep learning để xử lý ngữ cảnh và các mô hình AI để tạo ra câu trả lời phù hợp.
NLP hoạt động như thế nào? Quy trình xử lý ngôn ngữ tự nhiên
Để máy tính có thể hiểu và phản hồi ngôn ngữ của con người, NLP thường trải qua nhiều bước xử lý từ dữ liệu văn bản ban đầu đến kết quả cuối cùng. Mỗi bước đảm nhận một nhiệm vụ riêng, giúp biến câu chữ vốn khó xử lý trực tiếp thành dữ liệu mà mô hình AI có thể phân tích và đưa ra dự đoán. Quy trình cơ bản có thể được hình dung qua 4 bước sau:
Bước 1: Tiền xử lý văn bản (text preprocessing)
Tiền xử lý văn bản là bước đầu tiên trong quy trình xử lý ngôn ngữ tự nhiên, giúp làm sạch và chuẩn hóa dữ liệu ngôn ngữ trước khi đưa vào hệ thống phân tích. Văn bản con người thường chứa nhiều thành phần không cần thiết như dấu câu, ký tự đặc biệt, lỗi chính tả hoặc cách viết không thống nhất. Tiền xử lý giúp dữ liệu có cấu trúc rõ ràng hơn, từ đó tạo điều kiện để các bước tiếp theo phân tích chính xác và hiệu quả hơn.
Một số thao tác thường được thực hiện trong bước này gồm:
- Chuẩn hóa văn bản: Đưa văn bản về một định dạng thống nhất, chẳng hạn chuyển chữ hoa thành chữ thường hoặc chuẩn hóa khoảng trắng.
- Tách từ (tokenization): Chia câu hoặc đoạn văn thành các đơn vị nhỏ hơn như từ, cụm từ hoặc token để hệ thống có thể tiếp tục xử lý.
- Loại bỏ thành phần không cần thiết: Có thể loại bỏ một số dấu câu, ký tự đặc biệt, khoảng trắng thừa hoặc các thành phần không mang nhiều giá trị đối với bài toán cụ thể.
- Xử lý từ dừng (stop words): Xác định những từ xuất hiện phổ biến nhưng có thể không đóng góp nhiều cho việc phân tích, tùy theo mục tiêu của hệ thống.
- Chuẩn hóa từ: Đưa các cách viết hoặc dạng biến đổi của từ về dạng phù hợp để hệ thống nhận diện chính xác hơn mối liên hệ giữa chúng.
Bước 2: Biểu diễn ngôn ngữ dạng số (text representation)
Sau khi văn bản được làm sạch và chuẩn hóa, hệ thống xử lý ngôn ngữ tự nhiên cần chuyển ngôn ngữ thành dạng dữ liệu số để máy tính có thể xử lý. Máy tính không hiểu trực tiếp ý nghĩa của câu chữ như con người, vì vậy văn bản được chuyển thành các giá trị số hoặc vector đại diện cho từ, câu hoặc toàn bộ đoạn văn. Đây là bước quan trọng để mô hình có thể nhận diện mối quan hệ, mức độ tương đồng và ngữ cảnh giữa các thành phần trong văn bản.
Một số phương pháp biểu diễn văn bản phổ biến gồm:
- Bag of Words (BoW): Biểu diễn văn bản dựa trên số lần mỗi từ xuất hiện, phù hợp với những bài toán xử lý văn bản đơn giản nhưng chưa thể hiện tốt mối quan hệ ngữ nghĩa giữa các từ.
- TF-IDF: Đánh giá mức độ quan trọng của một từ dựa trên tần suất xuất hiện trong một văn bản và mức độ phổ biến của từ đó trong toàn bộ tập dữ liệu.
- Word Embedding: Chuyển mỗi từ thành một vector số, trong đó những từ có ý nghĩa hoặc ngữ cảnh sử dụng tương đồng thường có vị trí gần nhau trong không gian vector. Word2Vec và GloVe là những phương pháp biểu diễn phổ biến.
- Contextual Embedding: Không chỉ biểu diễn từ dựa trên bản thân từ đó mà còn xét đến ngữ cảnh xung quanh. Vì vậy, cùng một từ có thể được biểu diễn khác nhau tùy vào cách nó xuất hiện trong câu.
- Token Embedding trong mô hình ngôn ngữ hiện đại: Các mô hình như Transformer sử dụng vector để biểu diễn token và kết hợp thông tin ngữ cảnh nhằm giúp hệ thống hiểu mối quan hệ giữa nhiều thành phần trong câu.
Bước 3: Phân tích cú pháp & ngữ nghĩa (parsing & semantic analysis)
Sau khi văn bản được chuyển thành dạng số, hệ thống natural language processing cần xác định cấu trúc và ý nghĩa của nội dung. Đây là bước giúp máy tính hiểu các từ liên kết với nhau như thế nào trong câu, đâu là chủ thể, hành động, đối tượng và người dùng thực sự muốn truyền đạt điều gì. Hai khía cạnh quan trọng trong giai đoạn này là phân tích cú pháp (parsing) và phân tích ngữ nghĩa (semantic analysis).
- Phân tích cú pháp (parsing): Xác định cấu trúc ngữ pháp và mối quan hệ giữa các thành phần trong câu. Hệ thống có thể nhận diện danh từ, động từ, tính từ, chủ ngữ, vị ngữ hoặc mối quan hệ giữa các từ để hiểu cách câu được hình thành. Bước này giúp hệ thống hiểu rõ cấu trúc của câu hơn.
- Phân tích ngữ nghĩa (semantic analysis): Tập trung vào ý nghĩa của từ, cụm từ và toàn bộ câu trong một ngữ cảnh cụ thể. Hệ thống cần phân biệt những từ có nhiều nghĩa và xác định ý nghĩa phù hợp dựa trên các từ xung quanh.
Ví dụ, với câu “Tôi muốn mua một chiếc laptop dưới 20 triệu để làm thiết kế đồ họa”, hệ thống xử lý ngôn ngữ tự nhiên có thể phân tích:
- Ý định: Tìm mua laptop.
- Đối tượng: Laptop.
- Ngân sách: Dưới 20 triệu đồng.
- Mục đích sử dụng: Thiết kế đồ họa.
- Yêu cầu ngữ nghĩa: Tìm sản phẩm vừa phù hợp với ngân sách, vừa đáp ứng nhu cầu thiết kế đồ họa.
Nhờ phân tích này, website thương mại điện tử có thể ưu tiên hiển thị các mẫu laptop phù hợp với mức giá và nhu cầu sử dụng, thay vì chỉ trả về tất cả sản phẩm có chứa từ khóa “laptop”.
Bước 4: Đưa vào mô hình & xuất kết quả
Sau khi văn bản đã được làm sạch, chuyển thành dữ liệu số và phân tích về cú pháp, ngữ nghĩa, dữ liệu sẽ được đưa vào mô hình xử lý ngôn ngữ tự nhiên để xử lý và tạo ra kết quả. Mô hình dựa trên dữ liệu đã được huấn luyện để nhận diện mẫu, dự đoán ý định hoặc tạo nội dung phù hợp với yêu cầu đầu vào. Kết quả đầu ra sẽ phụ thuộc vào mục tiêu của từng hệ thống xử lý ngôn ngữ tự nhiên.
Một số dạng kết quả phổ biến gồm:
- Phân loại văn bản: Xác định văn bản thuộc một nhóm nội dung cụ thể, chẳng hạn phân loại email thành thư rác hoặc không phải thư rác.
- Xác định ý định người dùng: Với câu hỏi “Tôi muốn đổi mật khẩu tài khoản”, hệ thống có thể xác định người dùng đang cần hỗ trợ đổi mật khẩu và chuyển đến chức năng hoặc hướng dẫn tương ứng.
- Trả lời câu hỏi: Mô hình phân tích câu hỏi, tìm thông tin liên quan và tạo ra câu trả lời phù hợp.
- Dịch ngôn ngữ: Chuyển nội dung từ ngôn ngữ này sang ngôn ngữ khác nhưng vẫn cố gắng duy trì ý nghĩa và ngữ cảnh của câu.
- Tạo nội dung: Với các mô hình ngôn ngữ hiện đại, NLP có thể được sử dụng để tạo câu trả lời, tóm tắt văn bản, viết lại nội dung hoặc sinh nội dung theo yêu cầu.
Các mô hình & kỹ thuật NLP phổ biến từ truyền thống đến hiện đại
Xử lý ngôn ngữ tự nhiên đã phát triển từ những phương pháp xử lý ngôn ngữ dựa trên quy tắc và thống kê sang các mô hình học sâu có khả năng hiểu ngữ cảnh và tạo ngôn ngữ tự nhiên. Mỗi giai đoạn sử dụng những kỹ thuật khác nhau, phù hợp với khả năng tính toán và nhu cầu xử lý dữ liệu tại thời điểm đó.
1. Kỷ nguyên mô hình truyền thống
Mô hình NLP truyền thống chủ yếu dựa trên các quy tắc ngôn ngữ, tần suất xuất hiện của từ và xác suất thống kê. Các phương pháp này thường cần con người xác định trước nhiều đặc trưng của dữ liệu và có khả năng xử lý ngữ cảnh hạn chế hơn so với các mô hình hiện đại.
Một số kỹ thuật phổ biến gồm:
- Rule-based NLP: Sử dụng các quy tắc được thiết lập thủ công để phân tích và xử lý văn bản. Ví dụ, hệ thống có thể xác định một câu là câu hỏi nếu câu đó chứa những từ như “ai”, “ở đâu”, “khi nào” hoặc kết thúc bằng dấu hỏi.
- Bag of Words (BoW): Biểu diễn văn bản dựa trên tập hợp các từ xuất hiện trong văn bản và số lần xuất hiện của chúng. Phương pháp này tương đối đơn giản nhưng không thể hiện tốt thứ tự và mối quan hệ ngữ nghĩa giữa các từ.
- TF-IDF: Đánh giá mức độ quan trọng của một từ trong văn bản dựa trên tần suất xuất hiện của từ đó và mức độ phổ biến của nó trong toàn bộ tập dữ liệu. TF-IDF thường được sử dụng trong tìm kiếm thông tin và phân loại văn bản.
- N-gram: Phân tích một chuỗi gồm N từ hoặc token liên tiếp để mô hình có thể xem xét một phần ngữ cảnh khi xử lý câu. Ví dụ, bigram sử dụng các cặp từ liên tiếp, còn trigram sử dụng ba từ liên tiếp.
- Naive Bayes: Một thuật toán học máy dựa trên xác suất, thường được sử dụng cho các bài toán phân loại văn bản như phát hiện thư rác, phân loại chủ đề hoặc phân tích cảm xúc.
- Hidden Markov Model (HMM): Mô hình xác suất được sử dụng để xử lý các chuỗi dữ liệu, từng được ứng dụng trong nhận diện tiếng nói, gán nhãn từ loại và một số bài toán NLP khác.
Hạn chế của các phương pháp truyền thống là khả năng hiểu ngữ cảnh và mối quan hệ phức tạp giữa các từ còn hạn chế. Khi câu văn trở nên dài hoặc một từ có nhiều nghĩa khác nhau, hệ thống có thể gặp khó khăn trong việc xác định chính xác ý định và nội dung mà người dùng muốn truyền đạt. Đây cũng là một trong những lý do NLP dần chuyển sang word embedding, machine learning và deep learning trong các giai đoạn phát triển tiếp theo.
2. Kỷ nguyên học sâu (deep learning)
Deep learning đánh dấu bước chuyển quan trọng của NLP từ các phương pháp dựa nhiều vào đặc trưng được thiết kế thủ công sang các mô hình có khả năng tự học đặc trưng từ dữ liệu. Thay vì chỉ dựa vào tần suất xuất hiện của từ, các mô hình học sâu có thể học mối quan hệ phức tạp giữa các từ và thành phần trong câu. Nhờ đó, natural language processing có khả năng xử lý tốt hơn các bài toán như dịch máy, phân loại văn bản, nhận diện giọng nói và tạo nội dung.
Một số mô hình và kỹ thuật nổi bật trong giai đoạn này gồm:
- Word Embedding: Biểu diễn từ dưới dạng vector số, giúp mô hình nhận biết sự tương đồng về ngữ nghĩa giữa các từ. Các phương pháp như Word2Vec và GloVe giúp máy tính hiểu rằng những từ thường xuất hiện trong các ngữ cảnh tương tự có thể có mối quan hệ về mặt ý nghĩa.
- RNN (Recurrent Neural Network): Được thiết kế để xử lý dữ liệu theo chuỗi và có khả năng sử dụng thông tin từ những phần trước đó trong câu. Điều này giúp RNN phù hợp với các bài toán cần xem xét thứ tự của từ như dự đoán từ tiếp theo hoặc phân tích chuỗi văn bản.
- LSTM (Long Short-Term Memory): Là một biến thể của RNN, được thiết kế để xử lý tốt hơn các mối quan hệ phụ thuộc dài trong chuỗi dữ liệu. LSTM có khả năng duy trì những thông tin quan trọng trong thời gian dài hơn, giúp cải thiện hiệu quả khi xử lý các câu hoặc đoạn văn dài.
- GRU (Gated Recurrent Unit): Có cơ chế hoạt động tương tự LSTM nhưng cấu trúc đơn giản hơn. GRU giúp giảm độ phức tạp của mô hình nhưng vẫn có khả năng ghi nhớ thông tin trong chuỗi, vì vậy từng được sử dụng phổ biến trong nhiều bài toán NLP.
- CNN cho NLP: Mặc dù CNN thường được biết đến trong xử lý hình ảnh, kiến trúc này cũng có thể được sử dụng để phát hiện các mẫu hoặc cụm từ quan trọng trong văn bản. CNN từng được ứng dụng trong phân loại văn bản, phân tích cảm xúc và nhận diện đặc trưng ngôn ngữ.
Tuy nhiên, các mô hình RNN, LSTM và GRU vẫn gặp hạn chế khi phải xử lý những câu rất dài hoặc xác định mối quan hệ giữa các từ nằm cách xa nhau trong văn bản. Những hạn chế này thúc đẩy sự phát triển của Transformer, mở ra giai đoạn mới cho NLP hiện đại và đặt nền tảng cho nhiều mô hình ngôn ngữ lớn (LLM) ngày nay.
3. Kỷ nguyên transformer & large language models (LLM)
Transformer đánh dấu bước chuyển lớn của NLP hiện đại nhờ khả năng xử lý mối quan hệ giữa các từ trong một chuỗi thông qua cơ chế attention. Khác với RNN hay LSTM phải xử lý dữ liệu theo từng bước, Transformer có thể xem xét nhiều phần của câu cùng lúc, giúp mô hình xử lý ngữ cảnh hiệu quả hơn và có khả năng mở rộng với lượng dữ liệu lớn.
Một số mô hình và kỹ thuật nổi bật trong giai đoạn này gồm:
- Attention: Cơ chế giúp mô hình xác định mức độ liên quan giữa các từ hoặc token trong cùng một chuỗi. Nhờ attention, hệ thống có thể tập trung vào những thành phần quan trọng khi phân tích ý nghĩa của một câu.
- Transformer: Kiến trúc mạng nơ-ron được xây dựng dựa trên attention, tạo nền tảng cho nhiều mô hình NLP hiện đại. Transformer giúp cải thiện khả năng xử lý ngữ cảnh và có thể được huấn luyện trên lượng dữ liệu lớn.
- BERT (Bidirectional Encoder Representations from Transformers): Mô hình sử dụng Transformer để hiểu văn bản theo cả ngữ cảnh phía trước và phía sau của một từ. BERT phù hợp với các nhiệm vụ như phân loại văn bản, trả lời câu hỏi, nhận diện thực thể và phân tích ngữ nghĩa.
- GPT (Generative Pre-trained Transformer): Dòng mô hình Transformer tập trung vào khả năng tạo văn bản. Mô hình được huấn luyện trước trên lượng lớn dữ liệu ngôn ngữ, sau đó có thể thực hiện nhiều nhiệm vụ như trả lời câu hỏi, viết nội dung, tóm tắt hoặc chuyển đổi văn bản.
- Large Language Model (LLM): Là các mô hình ngôn ngữ có quy mô lớn, được huấn luyện trên khối lượng dữ liệu rất lớn với số lượng tham số cao. LLM có khả năng xử lý nhiều dạng yêu cầu ngôn ngữ và thực hiện nhiều nhiệm vụ mà không nhất thiết phải xây dựng một mô hình riêng cho từng tác vụ.
- Generative AI: Kết hợp các mô hình ngôn ngữ hiện đại với khả năng sinh nội dung mới dựa trên yêu cầu đầu vào. Trong website, công nghệ này có thể được sử dụng để tạo nội dung, chatbot, tóm tắt thông tin, hỗ trợ tìm kiếm hoặc tương tác với người dùng bằng ngôn ngữ tự nhiên.
Sự phát triển từ Transformer đến LLM đã mở rộng đáng kể phạm vi ứng dụng của NLP. Thay vì chỉ phân loại hoặc phân tích văn bản, các hệ thống hiện đại có thể hiểu ngữ cảnh, duy trì hội thoại, trả lời câu hỏi và tạo nội dung tương đối tự nhiên. Đây cũng là nền tảng cho nhiều trải nghiệm AI đang được tích hợp vào website, công cụ tìm kiếm, chatbot và các nền tảng số hiện nay.
Ứng dụng của NLP trong phát triển website
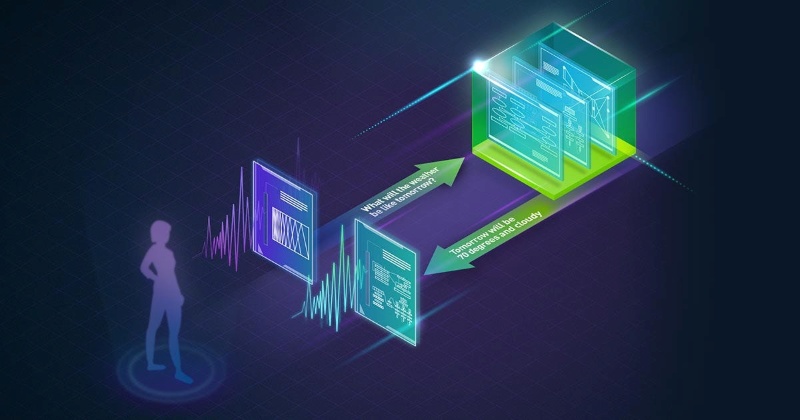
NLP đang được ứng dụng trong nhiều chức năng của website nhằm giúp hệ thống hiểu ngôn ngữ của người dùng và phản hồi theo đúng ngữ cảnh. Công nghệ này không chỉ hỗ trợ xử lý văn bản mà còn góp phần cải thiện tìm kiếm, chăm sóc khách hàng, cá nhân hóa nội dung và mở rộng website đến nhiều thị trường. Một số ứng dụng xử lý ngôn ngữ tự nhiên phổ biến gồm:
1. Tìm kiếm thông minh trên website
NLP giúp công cụ tìm kiếm hiểu ý định, ngữ cảnh và mối quan hệ giữa các từ trong truy vấn, thay vì chỉ tìm những trang chứa chính xác từ khóa mà người dùng nhập. Chẳng hạn, với truy vấn “điện thoại chụp ảnh đẹp dưới 10 triệu cho sinh viên”, hệ thống có thể xác định các yếu tố như loại sản phẩm, nhu cầu chụp ảnh, mức ngân sách và đối tượng sử dụng để lọc kết quả phù hợp. NLP cũng giúp xử lý những cách diễn đạt khác nhau nhưng có cùng ý nghĩa, từ đó hạn chế trường hợp người dùng không tìm thấy thông tin chỉ vì sử dụng một từ khóa khác với nội dung trên website.
Với website thương mại điện tử, tìm kiếm thông minh có thể kết hợp natural language processing với bộ lọc sản phẩm để người dùng nhanh chóng tìm được lựa chọn phù hợp. Với website dịch vụ hoặc tin tức, hệ thống có thể hiểu câu hỏi dài và đưa người dùng đến bài viết, dịch vụ hoặc trang thông tin liên quan. Nhờ đó, quá trình tìm kiếm trở nên tự nhiên hơn và người dùng không cần phải biết chính xác tên sản phẩm hay từ khóa mà website đang sử dụng.
2. Chatbot AI & trợ lý ảo chăm sóc khách hàng
Natural language processing giúp chatbot hiểu câu hỏi, xác định ý định và duy trì ngữ cảnh của cuộc hội thoại với người dùng. Thay vì chỉ phản hồi dựa trên một danh sách từ khóa cố định, chatbot có thể xử lý những câu hỏi được diễn đạt theo nhiều cách khác nhau. Ví dụ, các câu “Tôi muốn đổi hàng”, “Sản phẩm mua rồi có đổi được không?” hoặc “Chính sách đổi trả như thế nào?” có thể được hệ thống nhận diện là những câu hỏi liên quan đến chính sách đổi trả.
Khi được kết nối với dữ liệu của doanh nghiệp, chatbot có thể thực hiện nhiều nhiệm vụ hơn như tư vấn sản phẩm, giải đáp câu hỏi thường gặp, hướng dẫn quy trình, tra cứu đơn hàng hoặc tiếp nhận yêu cầu hỗ trợ. NLP cũng giúp hệ thống nhận diện những thông tin quan trọng trong câu hỏi như tên sản phẩm, mã đơn hàng, thời gian hoặc nhu cầu cụ thể. Điều này giúp giảm số lượng thao tác mà khách hàng phải thực hiện và tạo ra trải nghiệm tương tác tự nhiên hơn trên trang web.
3. Cá nhân hóa nội dung & hệ thống gợi ý
NLP có thể phân tích nội dung mà người dùng tìm kiếm, đọc và tương tác để xác định các chủ đề hoặc nhu cầu mà họ quan tâm. Chẳng hạn, nếu một người thường xuyên đọc các bài viết về chăm sóc da, hệ thống có thể nhận diện nhóm chủ đề này và đề xuất thêm nội dung, sản phẩm hoặc dịch vụ liên quan. Phân tích ngôn ngữ cũng giúp hệ thống hiểu mối quan hệ giữa các chủ đề thay vì chỉ dựa vào một từ khóa riêng lẻ.
Trên website thương mại điện tử, NLP có thể hỗ trợ xây dựng hệ thống gợi ý dựa trên đặc điểm và nội dung mô tả của sản phẩm. Trên website tin tức hoặc blog, công nghệ này có thể giúp đề xuất những bài viết có chủ đề tương đồng với nội dung người dùng đang đọc. Khi nội dung được cá nhân hóa phù hợp, người dùng có nhiều khả năng tiếp tục khám phá website thay vì phải tự tìm kiếm lại thông tin từ đầu.
4. Phân tích cảm xúc phản hồi
Natural language processing có thể phân tích đánh giá, bình luận, tin nhắn và phản hồi của khách hàng để xác định cảm xúc hoặc thái độ được thể hiện trong nội dung. Hệ thống có thể phân loại phản hồi theo các nhóm như tích cực, tiêu cực hoặc trung tính, đồng thời nhận diện những chủ đề mà khách hàng thường đề cập. Ví dụ, nhiều đánh giá tiêu cực cùng nhắc đến “giao hàng chậm” có thể cho thấy đây là một vấn đề cần được doanh nghiệp ưu tiên xử lý.
Ngoài xác định cảm xúc tổng thể, natural language processing còn có thể hỗ trợ phân tích phản hồi theo từng khía cạnh cụ thể như giá cả, chất lượng sản phẩm, giao hàng, thái độ phục vụ hoặc chính sách đổi trả. Doanh nghiệp có thể sử dụng dữ liệu này để phát hiện xu hướng trong trải nghiệm khách hàng và đánh giá hiệu quả của sản phẩm, dịch vụ. Tuy nhiên, kết quả phân tích vẫn cần được xem xét trong ngữ cảnh vì mỉa mai, tiếng lóng hoặc những câu diễn đạt phức tạp có thể khiến hệ thống hiểu sai cảm xúc thực tế.
5. Dịch thuật tự động đa ngôn ngữ
NLP giúp website dịch và xử lý nội dung bằng nhiều ngôn ngữ, tạo điều kiện để doanh nghiệp tiếp cận người dùng ở các thị trường khác nhau. Các hệ thống dịch hiện đại không chỉ chuyển đổi từng từ mà còn phân tích cấu trúc câu, ngữ cảnh và mối quan hệ giữa các thành phần để tạo ra bản dịch tự nhiên hơn. Điều này đặc biệt hữu ích với những website có lượng lớn nội dung như trang thương mại điện tử, website du lịch, tin tức hoặc nền tảng SaaS.
Chẳng hạn, một website bán hàng có thể sử dụng natural language processing để hỗ trợ dịch tên sản phẩm, mô tả, thông tin hướng dẫn và nội dung chăm sóc khách hàng sang nhiều ngôn ngữ. Người dùng ở từng thị trường có thể tiếp cận nội dung bằng ngôn ngữ quen thuộc mà doanh nghiệp không phải xử lý toàn bộ nội dung theo cách thủ công.
NLP trong SEO và thuật toán tìm kiếm của Google
Mô hình NLP đóng vai trò quan trọng trong cách các công cụ tìm kiếm phân tích truy vấn và hiểu nội dung trên website. Thay vì chỉ đối chiếu từ khóa, các hệ thống của Google có thể xem xét ngữ cảnh, ý định tìm kiếm, mối quan hệ giữa các khái niệm và thực thể để xác định nội dung phù hợp. Hiểu cách NLP được sử dụng trong tìm kiếm giúp người làm SEO xây dựng nội dung sát với nhu cầu người dùng và tối ưu website hiệu quả hơn.
1. Google ứng dụng NLP như thế nào?
Google sử dụng các mô hình học máy và kỹ thuật natural language processing để hiểu truy vấn tìm kiếm, xác định ngữ cảnh, kết nối các khái niệm và đánh giá mức độ liên quan của nội dung. Quá trình này giúp công cụ tìm kiếm không chỉ dựa vào việc đối chiếu từ khóa mà còn xem xét ý nghĩa mà người dùng muốn tìm kiếm và thông tin được thể hiện trên trang web.
- Hiểu ý định tìm kiếm theo ngữ cảnh với BERT và RankBrain: BERT giúp Google phân tích mối quan hệ giữa các từ trong một câu và hiểu ý nghĩa của truy vấn dựa trên toàn bộ ngữ cảnh. Điều này đặc biệt hữu ích với những truy vấn dài hoặc có các từ đóng vai trò quan trọng trong việc xác định ý nghĩa. Trong khi đó, RankBrain hỗ trợ Google hiểu mối liên hệ giữa các từ và khái niệm, từ đó tìm kiếm những nội dung phù hợp ngay cả khi trang web không sử dụng chính xác cụm từ mà người dùng nhập.
- Xử lý truy vấn phức tạp và nội dung đa phương thức: Google đã phát triển các hệ thống AI như MUM và Gemini để xử lý những nhiệm vụ tìm kiếm phức tạp hơn. Các mô hình này có khả năng làm việc với nhiều dạng thông tin và hỗ trợ Google hiểu mối quan hệ giữa văn bản, hình ảnh và các loại nội dung khác. Điều này mở rộng khả năng tìm kiếm từ việc trả về một danh sách liên kết sang hỗ trợ người dùng khám phá và tổng hợp thông tin cho những nhu cầu phức tạp.
- Nhận diện và kết nối các thực thể trong Knowledge Graph: NLP giúp Google nhận diện các thực thể như con người, địa điểm, tổ chức, thương hiệu, sản phẩm và khái niệm, đồng thời xác định mối quan hệ giữa chúng. Thay vì xem một trang web đơn thuần là tập hợp các từ khóa, hệ thống có thể xây dựng bối cảnh rộng hơn xoay quanh chủ đề được đề cập. Knowledge Graph là một trong những hệ thống giúp Google tổ chức và kết nối các thông tin về thực thể trong thế giới thực.
- Hỗ trợ tạo câu trả lời và tổng hợp thông tin bằng AI: Với sự phát triển của các hệ thống AI tạo sinh, Google có thể sử dụng AI để tổng hợp thông tin từ nhiều nguồn và cung cấp câu trả lời trực tiếp trong trang kết quả tìm kiếm thông qua các tính năng như AI Overviews. Điều này làm thay đổi cách người dùng tiếp cận thông tin, bởi họ có thể nhận được phần tổng hợp ban đầu trước khi truy cập vào các website nguồn. Vì vậy, nội dung website cần cung cấp thông tin rõ ràng, hữu ích và có giá trị độc lập thay vì chỉ tập trung vào việc lặp lại từ khóa.
- Đánh giá nội dung dựa trên mức độ hữu ích và chất lượng: NLP và các hệ thống học máy góp phần giúp Google hiểu nội dung trên trang, nhưng không nên hiểu rằng Google chỉ dùng NLP để chấm điểm độ “tự nhiên” của câu chữ. Hệ thống tìm kiếm sử dụng nhiều hệ thống và tín hiệu khác nhau để đánh giá mức độ liên quan, chất lượng và khả năng đáp ứng nhu cầu tìm kiếm. Vì vậy, nội dung SEO nên ưu tiên thông tin chính xác, chuyên sâu, dễ hiểu, đáp ứng đúng search intent và thể hiện trải nghiệm, chuyên môn, tính thẩm quyền và độ tin cậy phù hợp với chủ đề.
2. Cách tối ưu content website chuẩn NLP
Để công cụ tìm kiếm có thể hiểu đúng chủ đề, ngữ cảnh và mối quan hệ giữa các thông tin trong bài viết, nội dung nên được xây dựng dựa trên ngữ nghĩa, thực thể, cấu trúc thông tin rõ ràng và mức độ phù hợp với ý định tìm kiếm. Một số kỹ thuật quan trọng gồm:
- Tập trung vào thực thể (Entity-based Content): Xác định các thực thể quan trọng liên quan trực tiếp đến chủ đề, chẳng hạn như con người, tổ chức, sản phẩm, công nghệ, khái niệm hoặc địa điểm. Các thực thể cần được đề cập và liên kết với nhau theo những mối quan hệ có ý nghĩa, giúp công cụ tìm kiếm hiểu rõ hơn phạm vi và ngữ cảnh của nội dung. Ví dụ, khi viết về “Next.js”, nội dung có thể làm rõ mối quan hệ với “React”, “Server-Side Rendering”, “Static Site Generation” và “Vercel”.
- Mở rộng trường ngữ nghĩa và từ ngữ liên quan: Thay vì lặp lại một từ khóa xuyên suốt bài viết, nên sử dụng các từ đồng nghĩa, thuật ngữ chuyên ngành, cụm từ liên quan và những khái niệm thường xuất hiện cùng chủ đề. Cách triển khai này tạo nên một trường ngữ nghĩa nhất quán, giúp công cụ tìm kiếm có thêm dữ liệu để xác định chủ đề và mức độ bao phủ của bài viết.
- Cấu trúc nội dung theo mô hình Question - Answer: Đặt câu trả lời trực tiếp ngay sau tiêu đề H2 hoặc H3, sau đó mới mở rộng bằng phần giải thích, ví dụ và thông tin bổ sung. Cấu trúc này giúp người đọc nhanh chóng tiếp cận thông tin quan trọng, đồng thời tạo điều kiện thuận lợi cho các hệ thống tìm kiếm trong việc xác định và trích xuất những đoạn nội dung phù hợp để hiển thị trong các định dạng kết quả tìm kiếm.
- Ưu tiên văn phong tự nhiên và khả năng đọc hiểu (Readability): Sử dụng câu văn rõ ràng, có cấu trúc chủ ngữ - vị ngữ đầy đủ và sắp xếp thông tin theo trình tự logic. Hạn chế câu quá dài, cách diễn đạt vòng vo, lạm dụng thuật ngữ hoặc chèn từ khóa thiếu tự nhiên. Nội dung nên duy trì giọng văn nhất quán, dễ hiểu và phù hợp với đối tượng tìm kiếm.
- Xây dựng topic cluster và hệ thống liên kết nội bộ: Phát triển một trang nội dung trụ cột (Pillar Page) cùng các bài viết chuyên sâu xoay quanh từng chủ đề hoặc nhóm chủ đề cụ thể. Các bài viết cần được kết nối bằng internal link phù hợp, sử dụng anchor text mô tả đúng nội dung trang đích. Cấu trúc này giúp người dùng dễ dàng khám phá thông tin liên quan và hỗ trợ công cụ tìm kiếm hiểu mối quan hệ giữa các nội dung trong toàn bộ website.
Quy trình tích hợp NLP vào website chi tiết, chuyên nghiệp
Tích hợp ứng dụng xử lý ngôn ngữ tự nhiên vào website không đơn thuần là gọi một API bên ngoài vào giao diện, mà là quá trình đồng bộ giữa kỹ thuật phần mềm, cấu trúc dữ liệu và thiết kế trải nghiệm người dùng (UX). Một quy trình bài bản từ khâu xác định bài toán đến vận hành thực tế sẽ đảm bảo tính ổn định của hệ thống, giảm thiểu độ trễ phản hồi (latency), kiểm soát chi phí hạ tầng và mang lại giá trị thực tế cho doanh nghiệp. Dưới đây là 7 bước tích hợp NLP vào website chi tiết:
Bước 1: Xác định mục tiêu bài toán & lựa chọn usecase
Trước khi lựa chọn mô hình NLP, cần xác định rõ website đang muốn giải quyết vấn đề gì và kết quả đầu ra cần đạt được. Một số usecase phổ biến gồm tìm kiếm ngữ nghĩa, chatbot chăm sóc khách hàng, phân loại nội dung, phân tích cảm xúc, trích xuất thông tin hoặc hệ thống hỏi đáp tự động. Xác định đúng usecase giúp doanh nghiệp lựa chọn mô hình, dữ liệu và kiến trúc phù hợp thay vì triển khai AI theo xu hướng nhưng không tạo ra giá trị thực tế.
Ở bước này, nên mô tả bài toán theo đầu vào - quá trình xử lý - đầu ra. Chẳng hạn với tính năng tìm kiếm sản phẩm, đầu vào là truy vấn của người dùng như “laptop dưới 20 triệu để thiết kế đồ họa”, hệ thống cần xác định nhu cầu, ngân sách và đặc điểm sản phẩm, sau đó trả về danh sách phù hợp. Đồng thời, cần xác định các tiêu chí đánh giá như độ chính xác, thời gian phản hồi, số lượng người dùng và chi phí vận hành để làm cơ sở đo lường sau khi triển khai.
Bước 2: Lựa chọn phương án kiến trúc & mô hình NLP
Tùy thuộc vào ngân sách, năng lực hạ tầng, yêu cầu về hiệu năng và mức độ bảo mật dữ liệu, doanh nghiệp có thể cân nhắc ba phương án triển khai NLP phổ biến dưới đây:
- Sử dụng Cloud API có sẵn (SaaS / Third-party APIs): Doanh nghiệp có thể kết nối website với các dịch vụ natural language processing thông qua API của những nền tảng như OpenAI, Google Cloud NLP, AWS Comprehend hoặc Cohere. Phương án này phù hợp với các dự án cần triển khai nhanh vì doanh nghiệp không phải tự xây dựng, huấn luyện hay vận hành mô hình AI và cũng không cần đầu tư máy chủ GPU chuyên dụng. Tuy nhiên, chi phí thường phụ thuộc vào số lượng yêu cầu hoặc lượng dữ liệu xử lý, đồng thời hệ thống có mức độ phụ thuộc nhất định vào nhà cung cấp và cần được đánh giá kỹ về chính sách lưu trữ, xử lý dữ liệu và quyền riêng tư.
- Tự lưu trữ mô hình mã nguồn mở (Self-hosted Open Source): Với phương án này, doanh nghiệp triển khai mô hình NLP trên máy chủ riêng hoặc hạ tầng cloud có GPU, chẳng hạn như AWS EC2 hoặc các nền tảng cung cấp GPU chuyên dụng. Các mô hình từ Hugging Face như PhoBERT cho tiếng Việt, Llama hoặc Mistral có thể được lựa chọn tùy theo bài toán và yêu cầu tùy biến. Ưu điểm lớn của self-hosted là doanh nghiệp có quyền kiểm soát cao hơn đối với dữ liệu, cấu hình hệ thống và quá trình tùy chỉnh mô hình theo lĩnh vực nghiệp vụ. Ngược lại, phương án này đòi hỏi đội ngũ có năng lực triển khai và vận hành AI, đồng thời phát sinh chi phí hạ tầng, GPU, bảo trì, giám sát và nâng cấp mô hình.
- Kiến trúc tăng cường truy xuất dữ liệu (RAG - Retrieval-Augmented Generation): RAG kết hợp mô hình ngôn ngữ lớn (LLM) với nguồn dữ liệu riêng của doanh nghiệp thông qua một hệ thống truy xuất, thường sử dụng cơ sở dữ liệu vector như Pinecone, Qdrant, Milvus hoặc pgvector. Khi người dùng đặt câu hỏi, hệ thống sẽ tìm kiếm những tài liệu hoặc đoạn thông tin liên quan trong kho dữ liệu trước khi cung cấp chúng làm ngữ cảnh cho LLM tạo câu trả lời. Cách tiếp cận này đặc biệt phù hợp với chatbot, hệ thống hỏi đáp hoặc trợ lý AI cần khai thác tài liệu nội bộ thường xuyên cập nhật. Tuy nhiên, RAG không thể loại bỏ hoàn toàn hiện tượng hallucination; độ chính xác của câu trả lời vẫn phụ thuộc vào chất lượng dữ liệu, khả năng truy xuất và cách cấu hình mô hình.
Bước 3: Chuẩn bị & tiền xử lý dữ liệu nội bộ (data pipeline)
Độ chính xác và khả năng khai thác của hệ thống xử lý ngôn ngữ tự nhiên phụ thuộc đáng kể vào chất lượng, tính nhất quán và mức độ cập nhật của dữ liệu đầu vào. Trước khi đưa dữ liệu vào mô hình, doanh nghiệp cần xây dựng quy trình xử lý có hệ thống để dữ liệu được chuẩn hóa, phân đoạn và tổ chức phù hợp với mục đích truy xuất hoặc phân tích.
- Thu thập và trích xuất dữ liệu: Xác định các nguồn dữ liệu nội bộ có giá trị đối với bài toán natural language processing, chẳng hạn như bài viết blog, thông tin sản phẩm, tài liệu hướng dẫn, lịch sử hội thoại, câu hỏi thường gặp và đánh giá của người dùng. Dữ liệu có thể được trích xuất từ các hệ quản trị cơ sở dữ liệu như MySQL, PostgreSQL, MongoDB hoặc các hệ thống quản lý nội dung mà website đang sử dụng.
- Làm sạch và chuẩn hóa dữ liệu (Data Cleaning): Loại bỏ những thành phần không mang giá trị ngữ nghĩa như mã HTML dư thừa, ký tự lỗi, nội dung trùng lặp hoặc các trường dữ liệu không cần thiết. Đồng thời, cần kiểm tra và xử lý những nội dung đã lỗi thời, thiếu thông tin hoặc không còn phù hợp với nghiệp vụ để hạn chế việc hệ thống sử dụng dữ liệu không chính xác.
- Phân đoạn dữ liệu (Chunking): Với những tài liệu dài, nội dung cần được chia thành các đoạn nhỏ có ngữ nghĩa hoàn chỉnh để mô hình dễ xử lý và hệ thống truy xuất có thể xác định đúng phần thông tin liên quan. Kích thước chunk không nên áp dụng cứng nhắc cho mọi loại dữ liệu mà cần điều chỉnh theo cấu trúc tài liệu và mô hình sử dụng. Mỗi chunk cũng nên đi kèm metadata như ID sản phẩm, URL, tiêu đề, danh mục hoặc thời gian cập nhật để hỗ trợ quá trình lọc và truy xuất chính xác hơn.
- Tạo vector biểu diễn (Embedding Generation): Sau khi được làm sạch và phân đoạn, các khối dữ liệu được đưa qua mô hình embedding để chuyển nội dung văn bản thành các vector số học đại diện cho ý nghĩa ngữ nghĩa của chúng. Những vector này được lưu trữ trong cơ sở dữ liệu vector (Vector Database), từ đó hệ thống có thể thực hiện tìm kiếm theo ngữ nghĩa và xác định những nội dung có mức độ liên quan cao với truy vấn của người dùng.
Bước 4: Xây dựng backend API & lớp middleware
Sau khi hoàn thiện data pipeline và lựa chọn mô hình, doanh nghiệp cần xây dựng lớp backend để kết nối website với hệ thống NLP. Backend có nhiệm vụ tiếp nhận yêu cầu từ frontend, kiểm tra dữ liệu đầu vào, xác thực người dùng, gọi mô hình hoặc dịch vụ NLP và trả kết quả về giao diện. Lớp middleware có thể đảm nhiệm thêm các chức năng như authentication, phân quyền, rate limiting, logging, caching và kiểm soát lỗi nhằm đảm bảo hệ thống hoạt động an toàn và ổn định.
Với các hệ thống sử dụng LLM hoặc RAG, backend cũng cần quản lý luồng xử lý giữa người dùng, nguồn dữ liệu, vector database và mô hình AI. Việc tách riêng API và NLP service giúp hệ thống dễ bảo trì, kiểm soát chi phí và mở rộng khi lượng truy cập tăng. Đồng thời, doanh nghiệp nên thiết lập cơ chế timeout, retry và fallback để hạn chế tình trạng toàn bộ website bị ảnh hưởng khi dịch vụ NLP phản hồi chậm hoặc xảy ra lỗi.
Bước 5: Triển khai frontend UI/UX & tối ưu performance
Giao diện người dùng là lớp tương tác trực tiếp giữa khách truy cập và tính năng NLP, vì vậy cách trình bày phản hồi, tốc độ hiển thị và khả năng thao tác có ảnh hưởng lớn đến trải nghiệm tổng thể. Một giao diện được thiết kế tốt không chỉ giúp người dùng hiểu hệ thống đang xử lý yêu cầu mà còn hạn chế cảm giác chờ đợi và tạo điều kiện để họ khai thác tính năng natural language processing hiệu quả hơn.
- Tối ưu trạng thái phản hồi (Feedback & Loading States): Các tác vụ NLP, đặc biệt là những tính năng sử dụng LLM, có thể mất vài giây để xử lý. Vì vậy, giao diện nên hiển thị trạng thái loading phù hợp như skeleton, typing indicator hoặc thanh tiến trình thay vì để màn hình ở trạng thái trống. Với các tính năng sinh nội dung, có thể bổ sung nút dừng quá trình tạo, sao chép kết quả hoặc thực hiện lại yêu cầu để người dùng chủ động kiểm soát phiên tương tác.
- Xử lý bất đồng bộ và tối ưu hiệu năng: Tính năng NLP không nên làm ảnh hưởng đến khả năng tải và tương tác của các thành phần quan trọng trên website. Các framework như Next.js hoặc React có thể được sử dụng để tổ chức việc render phía máy chủ, phân tách client component và tải tài nguyên theo nhu cầu.
- Cung cấp gợi ý thông minh (Actionable Prompts): Thay vì yêu cầu người dùng tự nghĩ ra câu lệnh từ đầu, giao diện có thể cung cấp các prompt mẫu, prompt chips hoặc từ khóa tìm kiếm phổ biến ngay bên dưới ô nhập liệu. Những gợi ý này giúp người dùng nhanh chóng hiểu tính năng NLP có thể hỗ trợ những gì, đồng thời tạo ra các truy vấn có cấu trúc phù hợp hơn với khả năng xử lý của hệ thống.
- Thiết kế theo hướng Mobile-first: Với các website có lượng truy cập lớn từ thiết bị di động, giao diện của tính năng natural language processing cần được thiết kế ưu tiên cho màn hình nhỏ ngay từ đầu. Khung chat, ô nhập liệu, nút gửi và các thành phần tương tác cần có kích thước phù hợp với thao tác cảm ứng; đồng thời phải xử lý tốt bàn phím ảo, chiều cao màn hình và thao tác cuộn. Cách tiếp cận này giúp hạn chế tình trạng che khuất nội dung, vỡ bố cục hoặc khó thao tác khi người dùng sử dụng NLP trên smartphone.
Bước 6: Kiểm thử & giám sát hệ thống
Trước khi phát hành chính thức, hệ thống cần được đánh giá khắt khe về độ chính xác và khả năng chịu tải:
- Kiểm thử chất lượng câu trả lời (Evaluation & Benchmark): Đánh giá tính chính xác của thông tin bằng các bộ dữ liệu đối chuẩn (Ground Truth), kiểm tra khả năng xử lý câu hỏi bẫy, tiếng lóng địa phương và ngữ cảnh phức tạp.
- Kiểm thử tải (Load Testing): Sử dụng các công cụ như k6 hoặc Apache JMeter để mô phỏng hàng nghìn người dùng đồng thời truy vấn vào tính năng tìm kiếm hoặc chatbot, đảm bảo API không bị treo hoặc quá tải bộ nhớ.
- Thiết lập giám sát thời gian thực (Observability): Tích hợp công cụ giám sát (như Prometheus, Grafana, Datadog hoặc Helicone/Langfuse) để theo dõi độ trễ, tỷ lệ lỗi HTTP 5xx, lượng token tiêu thụ và chi phí vận hành hàng ngày.
Bước 7: Bảo trì, đào tạo liên tục
Sau khi đưa hệ thống NLP vào vận hành, doanh nghiệp cần duy trì hoạt động bảo trì, cập nhật dữ liệu và cải tiến mô hình theo thời gian. Nội dung website, thông tin sản phẩm, chính sách doanh nghiệp và nhu cầu tìm kiếm của người dùng có thể thay đổi, khiến dữ liệu ban đầu dần trở nên lỗi thời. Vì vậy, cần xây dựng quy trình rà soát định kỳ để cập nhật nguồn dữ liệu, kiểm tra chất lượng đầu ra và loại bỏ những thông tin không còn chính xác.
Với các hệ thống sử dụng mô hình có khả năng học hoặc được tinh chỉnh theo dữ liệu riêng, doanh nghiệp có thể bổ sung dữ liệu mới, điều chỉnh prompt, tối ưu retrieval hoặc fine-tuning khi cần thiết. Những truy vấn mà hệ thống xử lý chưa chính xác cũng nên được ghi nhận để phân tích nguyên nhân và đưa vào tập dữ liệu đánh giá cho các vòng cải tiến tiếp theo. Tuy nhiên, không phải hệ thống nào cũng cần “đào tạo lại” mô hình thường xuyên; với các hệ thống RAG, cập nhật knowledge base và cải thiện cơ chế truy xuất có thể quan trọng hơn việc huấn luyện lại LLM.
Những thách thức lớn khi triển khai natural language processing
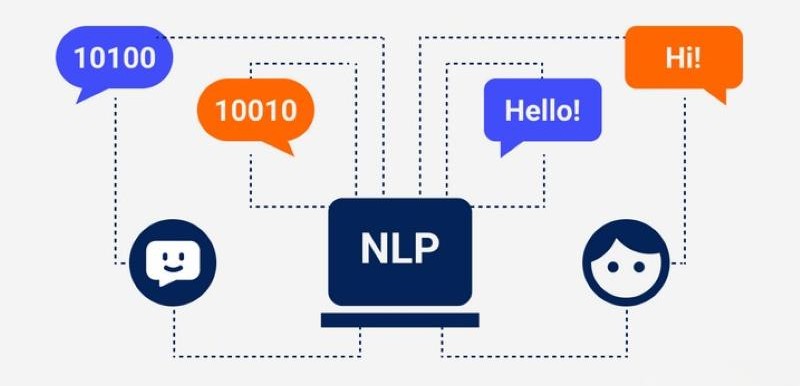
Natural language processing mang lại nhiều giá trị cho website nhưng quá trình triển khai vẫn tồn tại những thách thức liên quan đến ngôn ngữ, dữ liệu, hạ tầng và bảo mật. Doanh nghiệp cần đánh giá các yếu tố này ngay từ giai đoạn thiết kế để lựa chọn mô hình, kiến trúc và phương án vận hành phù hợp.
- Sự phức tạp, tính đa nghĩa và yếu tố văn hóa của ngôn ngữ: Ngôn ngữ tự nhiên có thể thay đổi ý nghĩa tùy theo ngữ cảnh, cách diễn đạt, tiếng lóng, lỗi chính tả hoặc đặc điểm văn hóa, vùng miền. Điều này khiến mô hình NLP có thể hiểu sai ý định hoặc đưa ra kết quả chưa phù hợp, đặc biệt với các truy vấn ngắn, mơ hồ hoặc chứa nhiều cách hiểu. Vì vậy, hệ thống cần được kiểm thử với nhiều cách diễn đạt khác nhau thay vì chỉ đánh giá dựa trên một nhóm câu hỏi.
- Đặc thù riêng của tiếng Việt (Vietnamese NLP): Tiếng Việt có những đặc điểm riêng như vấn đề tách từ, từ đồng âm, từ đa nghĩa, cách viết không dấu và nhiều biến thể ngôn ngữ trên môi trường Internet. Vì vậy, hệ thống NLP tiếng Việt cần sử dụng mô hình và dữ liệu phù hợp để đảm bảo khả năng phân tích ngữ nghĩa và hiểu đúng ngữ cảnh.
- Chất lượng và khối lượng dữ liệu: Dữ liệu thiếu, trùng lặp, lỗi thời hoặc chứa nhiều thông tin nhiễu có thể làm giảm độ chính xác của hệ thống natural language processing. Doanh nghiệp cần đầu tư vào quá trình thu thập, làm sạch, chuẩn hóa và cập nhật dữ liệu thay vì chỉ tập trung gia tăng số lượng dữ liệu.
- Chi phí hạ tầng và khả năng mở rộng: Các hệ thống NLP, đặc biệt khi sử dụng LLM hoặc mô hình cần GPU, có thể phát sinh chi phí cho API, máy chủ, lưu trữ, vector database và vận hành. Khi lượng truy cập tăng, kiến trúc hệ thống cũng cần được tối ưu để đảm bảo hiệu năng và kiểm soát chi phí.
- Bảo mật & quyền riêng tư: Natural language processing có thể xử lý dữ liệu khách hàng, lịch sử hội thoại, tài liệu nội bộ hoặc thông tin nghiệp vụ nên cần được kiểm soát chặt chẽ. Doanh nghiệp cần xác định phạm vi dữ liệu được phép xử lý, áp dụng phân quyền, mã hóa và lựa chọn phương án triển khai phù hợp với yêu cầu bảo mật.
Qua bài viết của Phương Nam Vina, có thể thấy NLP đang trở thành một thành phần quan trọng giúp website hiểu tốt hơn ngôn ngữ và nhu cầu của người dùng từ tìm kiếm thông minh, chatbot, cá nhân hóa nội dung đến phân tích dữ liệu và hỗ trợ SEO. Tuy nhiên, hiệu quả của NLP không chỉ phụ thuộc vào mô hình mà còn đến từ chất lượng dữ liệu, kiến trúc hệ thống, trải nghiệm UI/UX, hiệu năng và khả năng bảo mật. Vì vậy, doanh nghiệp nên bắt đầu từ một usecase cụ thể, lựa chọn phương án triển khai phù hợp với nguồn lực và liên tục đo lường, cải tiến trong quá trình vận hành. Khi được xây dựng đúng cách, natural language processing có thể trở thành nền tảng giúp website nâng cao trải nghiệm người dùng và khai thác dữ liệu hiệu quả hơn.
Tham khảo thêm:
 Xây dựng hệ thống web linh hoạt với event-driven architecture
RBAC là gì? Hướng dẫn triển khai RBAC cho hệ thống website
Monolithic architecture là gì? Đặc điểm của kiến trúc nguyên khối