

Khi website ngày càng phát triển, khối lượng dữ liệu tăng cao có thể khiến máy chủ quá tải, ảnh hưởng đến hiệu suất và trải nghiệm người dùng. Batch processing (xử lý theo lô) ra đời như một giải pháp giúp gom nhóm và xử lý dữ liệu theo lịch trình hoặc điều kiện xác định, tối ưu tài nguyên và nâng cao hiệu quả vận hành. Vậy batch processing là gì, hoạt động ra sao và đâu là những công cụ phù hợp? Hãy cùng tìm hiểu để lựa chọn giải pháp xử lý dữ liệu hiệu quả, giúp website vận hành ổn định và sẵn sàng mở rộng trong tương lai.
- Batch processing là gì?
- Dấu hiệu nhận biết hệ thống website cần áp dụng batch processing
- Cơ chế vận hành và kiến trúc chuẩn của hệ thống batch processing
- Các phương thức triển khai batch processing phổ biến
- So sánh batch processing vs stream processing, real-time processing
- Ứng dụng thực tiễn của batch processing trong phát triển website
- Các công cụ và hệ sinh thái công nghệ triển khai batch processing
- Nguyên tắc thiết kế hệ thống batch processing chịu lỗi tốt
- 1. Đảm bảo tính bất biến (idempotency)
- 2. Kỹ thuật chia khối (chunking) và phân trang (paging)
- 3. Xử lý lỗi linh hoạt (checkpointing, retry logic & dead-letter queue)
- 4. Phân bổ thời gian thực thi (off-peak scheduling) và kiểm soát tốc độ (throttling)
- 5. Giám sát toàn diện (monitoring, alerting & metrics)
Batch processing là gì?
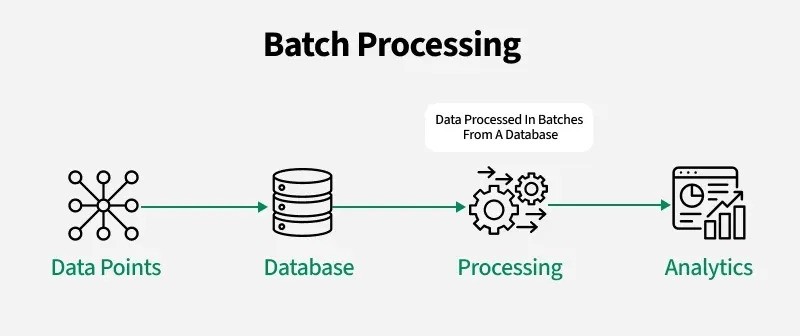
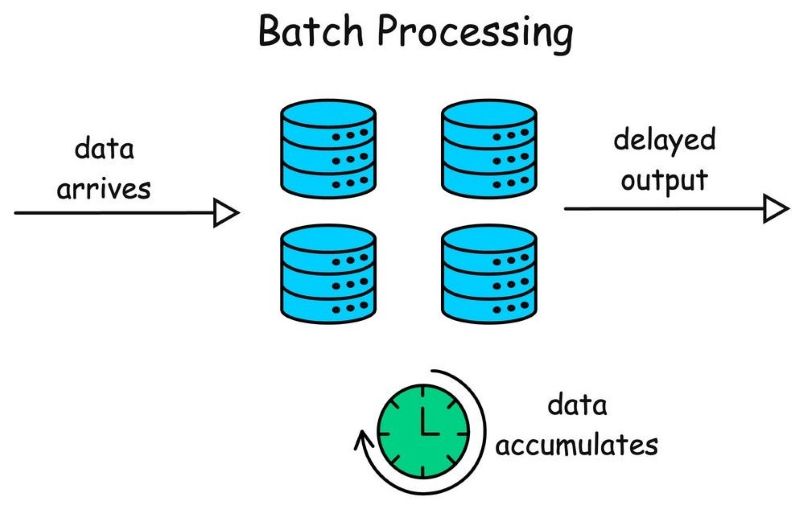
Batch processing (xử lý theo lô) là phương pháp thu thập nhiều bản ghi hoặc tác vụ, tập hợp chúng thành một nhóm rồi xử lý theo quy trình đã thiết lập mà không yêu cầu hệ thống phải phản hồi riêng cho từng yêu cầu ngay tại thời điểm phát sinh. Các tác vụ thường được thực hiện theo lịch định kỳ, khi đạt đủ số lượng dữ liệu hoặc khi xuất hiện một điều kiện kích hoạt cụ thể.
Batch processing thường phù hợp với các công việc không cần cập nhật kết quả ngay lập tức, chẳng hạn như tổng hợp báo cáo doanh thu, đồng bộ dữ liệu, gửi email theo chiến dịch và tái lập chỉ mục tìm kiếm. Với những tác vụ cần phản hồi ngay khi sự kiện xảy ra, bạn nên cân nhắc kết hợp xử lý theo lô với hàng đợi tác vụ, xử lý luồng hoặc cơ chế xử lý đồng bộ tùy theo yêu cầu của hệ thống.
Dấu hiệu nhận biết hệ thống website cần áp dụng batch processing
Không phải tác vụ nào trên website cũng cần xử lý theo lô, nhưng khi khối lượng công việc tăng lên hoặc các thao tác lặp lại bắt đầu gây áp lực lên máy chủ, batch processing có thể giúp cải thiện hiệu suất vận hành. Bạn có thể xem xét phương pháp này khi hệ thống xuất hiện những dấu hiệu sau:
- Số lượng bản ghi cần xử lý ngày càng lớn: Website thường xuyên nhập dữ liệu từ nhiều nguồn, cập nhật hàng nghìn sản phẩm hoặc xử lý lượng giao dịch lớn khiến việc thực hiện từng bản ghi riêng lẻ trở nên tốn tài nguyên.
- Các tác vụ nền chiếm nhiều tài nguyên máy chủ: Việc tạo báo cáo, nén ảnh, xuất dữ liệu hoặc gửi thông báo làm tăng mức sử dụng CPU, RAM và kết nối cơ sở dữ liệu trong giờ cao điểm.
- Nhiều công việc có thể thực hiện theo lịch: Những tác vụ như tổng hợp số liệu cuối ngày, làm sạch dữ liệu, sao lưu hoặc đồng bộ thông tin không cần chạy ngay sau mỗi thay đổi.
- Các thao tác lặp lại gây ra nhiều truy vấn nhỏ: Hệ thống phải cập nhật từng bản ghi hoặc gọi API nhiều lần cho những công việc có thể gom nhóm để giảm chi phí xử lý.
- Thời gian phản hồi của website bị ảnh hưởng: Các công việc nặng chạy trực tiếp trong yêu cầu của người dùng có thể làm trang tải chậm hoặc khiến thao tác bị chờ lâu.
- Quy trình cần khả năng chạy lại và kiểm soát lỗi: Những công việc quan trọng như đồng bộ dữ liệu, xử lý đơn hàng theo đợt hoặc xuất báo cáo cần lưu trạng thái để tiếp tục từ phần chưa hoàn tất.
- Dữ liệu cần được tổng hợp trước khi sử dụng: Hệ thống phân tích hành vi, báo cáo kinh doanh hoặc kho dữ liệu thường cần gom nhiều bản ghi trước khi tính toán và xuất kết quả.
Khi nhận thấy một hoặc nhiều dấu hiệu trên, bạn nên đánh giá tần suất xử lý, dung lượng dữ liệu, mức độ ưu tiên và yêu cầu về độ trễ của từng tác vụ. Đây là cơ sở để xác định công việc nào nên chạy theo lô, công việc nào cần xử lý tức thời và cách kết hợp hai phương pháp để cân bằng hiệu suất với trải nghiệm người dùng.
Cơ chế vận hành và kiến trúc chuẩn của hệ thống batch processing
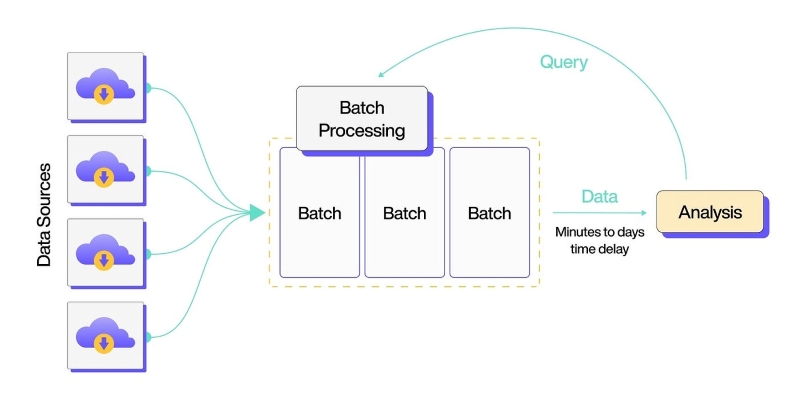
Một hệ thống batch processing thường được tổ chức thành nhiều thành phần phối hợp với nhau, từ khâu tiếp nhận dữ liệu đến thực thi tác vụ và lưu kết quả. Kiến trúc này giúp bạn kiểm soát quy trình xử lý, theo dõi tiến độ và hạn chế ảnh hưởng đến các hoạt động đang diễn ra trên website.
1. Quy trình xử lý dữ liệu 4 giai đoạn
Quy trình batch processing gồm bốn giai đoạn chính, mỗi giai đoạn đảm nhận một nhiệm vụ riêng. Sự phối hợp giữa các giai đoạn giúp dữ liệu được xử lý đúng trình tự, đảm bảo tính chính xác và hiệu quả vận hành.
- Giai đoạn 1: Thu thập và tập hợp dữ liệu: Hệ thống lấy dữ liệu từ cơ sở dữ liệu, tệp tin, API hoặc hàng đợi tác vụ, sau đó tập hợp các bản ghi đáp ứng điều kiện xử lý. Dữ liệu có thể được phân nhóm theo thời gian, loại tác vụ, trạng thái hoặc số lượng bản ghi.
- Giai đoạn 2: Kiểm tra và chuẩn hóa dữ liệu: Trước khi xử lý, hệ thống xác thực định dạng, loại bỏ dữ liệu không hợp lệ, kiểm tra bản ghi trùng lặp và chuyển đổi thông tin về cấu trúc thống nhất. Bước này giúp giảm lỗi trong các công đoạn tính toán hoặc cập nhật tiếp theo.
- Giai đoạn 3: Thực thi batch job: Bộ xử lý thực hiện các tác vụ đã xác định, chẳng hạn như cập nhật dữ liệu, tính toán tổng doanh thu, tạo ảnh thu nhỏ hoặc gửi email. Tùy kiến trúc, công việc có thể chạy tuần tự, song song hoặc phân chia thành nhiều nhóm nhỏ.
- Giai đoạn 4: Ghi kết quả và giám sát: Hệ thống lưu kết quả, cập nhật trạng thái hoàn thành, ghi nhận các bản ghi lỗi và thống kê thời gian thực thi. Nếu một phần công việc thất bại, hệ thống có thể chạy lại phần đó theo chính sách phục hồi đã thiết lập.
2. Các thành phần cấu trúc cốt lõi trong một batch job
Batch job là một công việc cụ thể được thiết lập để thực hiện theo lô, chẳng hạn như xuất dữ liệu khách hàng hoặc cập nhật trạng thái hàng nghìn sản phẩm. Để batch job vận hành ổn định, hệ thống thường cần các thành phần cốt lõi sau.
- Data source (nguồn dữ liệu): Cung cấp bản ghi đầu vào từ cơ sở dữ liệu, API, tệp CSV, hệ thống lưu trữ hoặc hàng đợi tác vụ.
- Job scheduler (bộ lập lịch): Xác định thời điểm khởi chạy công việc, chu kỳ thực thi và các điều kiện kích hoạt.
- Job processor (bộ xử lý): Thực hiện logic nghiệp vụ, tính toán, chuyển đổi dữ liệu hoặc gọi các dịch vụ liên quan.
- Queue và job dispatcher (hàng đợi và bộ phân phối): Lưu danh sách công việc chờ xử lý, phân phối tác vụ cho worker và điều tiết tốc độ thực thi khi kiến trúc có sử dụng hàng đợi.
- Worker (tiến trình thực thi): Nhận tác vụ và xử lý dữ liệu theo cấu hình, có thể chạy nhiều worker để tăng thông lượng.
- Storage và output handler (lưu trữ và ghi kết quả): Ghi dữ liệu đã xử lý vào cơ sở dữ liệu, kho dữ liệu, hệ thống tệp hoặc dịch vụ đích.
- Logging và monitoring (ghi nhật ký và giám sát): Theo dõi tiến độ, thời gian xử lý, tỷ lệ lỗi và các chỉ số tài nguyên để hỗ trợ vận hành.
Các phương thức triển khai batch processing phổ biến
Batch processing có thể được triển khai theo nhiều phương thức tùy thuộc vào thời điểm dữ liệu xuất hiện, khối lượng công việc và yêu cầu hoàn thành. Việc lựa chọn đúng cơ chế kích hoạt giúp bạn tránh xử lý quá thường xuyên khi chưa cần thiết, đồng thời bảo đảm dữ liệu được cập nhật trong khoảng thời gian phù hợp.
1. Xử lý định kỳ theo thời gian (time-driven / scheduled batch)
Time-driven batch processing là phương pháp tự động khởi chạy các tác vụ theo lịch trình được thiết lập trước, chẳng hạn mỗi 5 phút, mỗi giờ, cuối ngày hoặc đầu tháng. Bộ lập lịch sẽ kích hoạt batch job theo mốc thời gian tương ứng, giúp hệ thống thu thập và xử lý dữ liệu theo lô một cách nhất quán, giảm thao tác thủ công và đảm bảo công việc được thực hiện đúng lịch.
Các tác vụ định kỳ thường được áp dụng trong nhiều hoạt động vận hành website nhằm đảm bảo dữ liệu luôn được cập nhật và hệ thống hoạt động ổn định. Ví dụ, hệ thống có thể tự động tổng hợp doanh thu, đồng bộ dữ liệu sản phẩm, làm sạch dữ liệu, cập nhật trạng thái tài khoản, tạo báo cáo truy cập, gửi email tổng hợp và thực hiện sao lưu hoặc bảo trì theo lịch.
2. Xử lý theo sự kiện kích hoạt (event-driven batch)
Event-driven batch là phương thức bắt đầu xử lý khi một sự kiện hoặc điều kiện nghiệp vụ được ghi nhận, chẳng hạn khi một chiến dịch kết thúc, một tệp dữ liệu được tải lên hoặc một nhóm đơn hàng chuyển sang trạng thái sẵn sàng. Hệ thống thu thập các tác vụ liên quan đến sự kiện rồi gom chúng thành một lô để xử lý.
Khác với batch processing định kỳ dựa trên mốc thời gian, event-driven batch processing kích hoạt xử lý theo các sự kiện thực tế, giúp giảm thời gian chờ khi dữ liệu sẵn sàng. Phương pháp này thường được ứng dụng để xử lý danh sách sản phẩm sau khi nhập tệp CSV, đồng bộ dữ liệu khi hoàn tất cập nhật từ hệ thống nguồn, tạo báo cáo sau chiến dịch quảng cáo hoặc khuyến mãi và xử lý các nhóm giao dịch khi đạt trạng thái nghiệp vụ xác định.
3. Xử lý theo ngưỡng dung lượng dữ liệu (threshold/size-driven batch)
Threshold-driven batch processing là phương pháp kích hoạt xử lý khi lượng dữ liệu tích lũy đạt đến ngưỡng được xác định trước, chẳng hạn số lượng bản ghi, dung lượng dữ liệu hoặc số tác vụ nhất định. Hệ thống sẽ liên tục theo dõi dữ liệu đang chờ và bắt đầu xử lý khi đáp ứng điều kiện đã thiết lập.
Phương pháp này phù hợp với các hệ thống tiếp nhận dữ liệu liên tục nhưng không cần xử lý ngay từng bản ghi. Một số ứng dụng phổ biến gồm gom nhật ký truy cập để phân tích, tập hợp giao dịch trước khi lưu vào kho dữ liệu, gộp yêu cầu cập nhật sản phẩm nhằm giảm số lần gọi API và thu thập sự kiện người dùng để tạo báo cáo phân tích.
4. Xử lý theo vi lô (micro-batch processing)
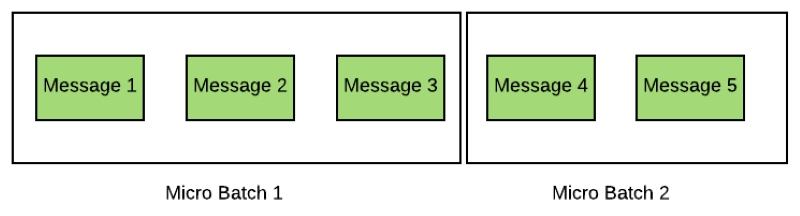
Micro-batch processing là phương pháp chia luồng dữ liệu thành các lô nhỏ để xử lý liên tục theo khoảng thời gian ngắn hoặc khi đạt đến một lượng dữ liệu nhất định. Cách tiếp cận này giúp giảm độ trễ, tối ưu tài nguyên và phù hợp với các tác vụ như cập nhật bảng điều khiển phân tích, tổng hợp sự kiện người dùng, đồng bộ dữ liệu từ nhiều nguồn và xử lý nhật ký hệ thống gần thời gian thực.
So sánh batch processing vs stream processing, real-time processing
Batch processing vs stream processing và real-time processing đều được sử dụng để xử lý dữ liệu, nhưng khác nhau về cách tiếp nhận thông tin, thời gian phản hồi và yêu cầu vận hành. Hiểu rõ sự khác biệt giữa batch là gì và các phương pháp sẽ giúp bạn lựa chọn kiến trúc phù hợp với từng chức năng của website.
| Tiêu chí | Batch processing | Stream processing | Real-time processing |
| Cách xử lý | Gom dữ liệu thành lô rồi xử lý | Xử lý luồng sự kiện liên tục | Xử lý và phản hồi trong thời gian đáp ứng mục tiêu |
| Thời điểm thực thi | Theo lịch hoặc điều kiện kích hoạt | Khi dữ liệu đi vào luồng | Khi phát sinh yêu cầu hoặc sự kiện cần phản hồi |
| Độ trễ | Từ vài giây đến nhiều giờ, tùy cấu hình | Thường thấp, từ mili giây đến vài giây | Phải đáp ứng giới hạn thời gian xác định |
| Khối lượng dữ liệu | Phù hợp với khối lượng lớn được tích lũy | Phù hợp với dữ liệu liên tục | Tùy yêu cầu và năng lực hệ thống |
| Khả năng ứng dụng | Báo cáo, ETL, gửi email hàng loạt | Theo dõi hành vi, phát hiện sự kiện, phân tích luồng | Xác thực thanh toán, kiểm tra tồn kho khi đặt hàng |
| Công nghệ thường gặp | Spring Batch, Apache Spark, cron | Apache Kafka, Apache Flink, Spark Structured Streaming | API đồng bộ, hệ thống xử lý sự kiện và các dịch vụ có yêu cầu độ trễ thấp |
Ứng dụng thực tiễn của batch processing trong phát triển website
Trong lĩnh vực phát triển website, batch processing tools thường được sử dụng để chuyển các công việc tốn nhiều tài nguyên sang tiến trình nền, giúp yêu cầu của người dùng được phản hồi nhanh hơn. Tùy vào mục tiêu vận hành, bạn có thể áp dụng phương pháp này cho cơ sở dữ liệu, báo cáo, email marketing, tệp đa phương tiện và nhiều quy trình kỹ thuật khác.
1. Xử lý dữ liệu hàng loạt trong cơ sở dữ liệu
Batch processing tools giúp website thực hiện nhiều thao tác thêm, cập nhật hoặc xóa dữ liệu trong một đợt thay vì gửi từng yêu cầu riêng lẻ. Cách làm này giảm số lần giao tiếp với cơ sở dữ liệu, hạn chế chi phí xử lý và cải thiện hiệu suất khi phải thao tác với lượng bản ghi lớn.
Ví dụ, website thương mại điện tử có thể sử dụng batch processing tools để cập nhật giá sản phẩm, điều chỉnh số lượng tồn kho hoặc thay đổi trạng thái hàng nghìn đơn hàng. Các tác vụ được chia thành từng nhóm dữ liệu để xử lý, giúp kiểm soát tải hệ thống và hạn chế ảnh hưởng đến những truy vấn đang phục vụ người dùng.
2. Tổng hợp số liệu và kết xuất báo cáo định kỳ
Các báo cáo doanh thu, đơn hàng, lượt truy cập hoặc hiệu quả kinh doanh thường cần tổng hợp dữ liệu từ nhiều nguồn. Thay vì tính toán lại mỗi khi người dùng mở trang báo cáo, hệ thống có thể chạy batch processing theo giờ, ngày hoặc tháng để chuẩn bị dữ liệu trước.
Chẳng hạn, website bán hàng có thể tự động tổng hợp doanh thu cuối ngày, thống kê sản phẩm bán chạy và phân loại đơn hàng theo trạng thái. Kết quả được lưu lại để quản trị viên truy cập nhanh chóng mà không phải chờ hệ thống truy vấn và tính toán trên lượng dữ liệu lớn mỗi lần xem báo cáo.
3. Gửi thông báo đẩy và email marketing hàng loạt
Batch processing hỗ trợ phân phối email marketing và thông báo đẩy đến số lượng lớn người dùng theo từng nhóm. Hệ thống có thể lấy danh sách người nhận, kiểm tra điều kiện gửi, cá nhân hóa nội dung rồi đưa thông điệp vào hàng đợi để xử lý lần lượt hoặc song song.
Ví dụ như website thương mại điện tử có thể gửi email xác nhận chương trình khuyến mãi, thông báo sản phẩm mới hoặc nhắc khách hàng về giỏ hàng chưa hoàn tất. Việc chia danh sách thành các lô giúp kiểm soát tốc độ gửi, giảm nguy cơ quá tải và thuận tiện theo dõi những thông báo gửi thành công hoặc thất bại.
4. Xử lý và tối ưu hóa tệp tin đa phương tiện
Website có thư viện ảnh, video hoặc tài liệu lớn thường cần xử lý tệp trước khi đưa vào sử dụng. Batch processing cho phép hệ thống thực hiện các công việc như thay đổi kích thước ảnh, chuyển đổi định dạng, nén dung lượng, tạo ảnh thu nhỏ hoặc trích xuất thông tin từ nhiều tệp trong cùng một đợt.
Trong thực tế, khi quản trị viên tải lên hàng trăm hình ảnh sản phẩm, hệ thống có thể đưa chúng vào hàng đợi để tạo các phiên bản phù hợp với ảnh đại diện, trang chi tiết và giao diện di động. Công việc được thực hiện ở tiến trình nền nên không cần giữ yêu cầu tải trang trong suốt thời gian xử lý, đồng thời giúp chuẩn hóa hình ảnh trên toàn website.
5. Trích xuất và đồng bộ dữ liệu vào data warehouse (ETL)
Batch processing thường được sử dụng trong quy trình ETL (extract, transform, load), gồm trích xuất dữ liệu từ nguồn, chuyển đổi theo cấu trúc cần thiết và tải vào hệ thống lưu trữ hoặc phân tích tập trung. Các bước này có thể chạy theo lịch để tổng hợp dữ liệu từ website, hệ thống bán hàng, CRM hoặc những nền tảng liên quan.
Doanh nghiệp có thể đồng bộ dữ liệu đơn hàng, thông tin khách hàng và lịch sử truy cập vào data warehouse mỗi đêm. Sau khi dữ liệu được làm sạch và chuẩn hóa, đội ngũ phân tích có thể sử dụng chúng để lập báo cáo, theo dõi xu hướng kinh doanh hoặc xây dựng mô hình dự đoán mà không gây thêm tải đáng kể cho cơ sở dữ liệu vận hành.
6. Tái lập chỉ mục tìm kiếm cho hệ thống website
Khi website có nhiều nội dung hoặc sản phẩm thường xuyên thay đổi, hệ thống tìm kiếm cần cập nhật chỉ mục để kết quả hiển thị chính xác. Batch processing tools cho phép thu thập, xử lý và lập chỉ mục một nhóm bản ghi theo lịch hoặc sau khi có nhiều thay đổi, thay vì cập nhật toàn bộ chỉ mục sau từng thao tác riêng lẻ.
Cách này giúp giảm số lần xử lý lặp lại và sử dụng tài nguyên hiệu quả hơn. Tuy nhiên, với những dữ liệu cần phản ánh gần như ngay lập tức, hệ thống nên kết hợp cơ chế cập nhật theo sự kiện để tránh kết quả tìm kiếm bị lỗi thời quá lâu.
Các công cụ và hệ sinh thái công nghệ triển khai batch processing
Việc lựa chọn batch processing tools phụ thuộc vào ngôn ngữ lập trình, quy mô dữ liệu, hạ tầng và mức độ phức tạp của quy trình nghiệp vụ. Với website nhỏ, bạn có thể bắt đầu từ bộ lập lịch và hàng đợi tác vụ ở tầng ứng dụng, trong khi hệ thống dữ liệu lớn có thể cần framework phân tán hoặc nền tảng điều phối chuyên dụng.
1. Framework xử lý hàng đợi tác vụ ở tầng ứng dụng web
Nhóm công cụ này hỗ trợ tạo, lưu trữ, phân phối và thực thi tác vụ nền trong ứng dụng web. Chúng phù hợp với các công việc như gửi email, xử lý ảnh, đồng bộ dữ liệu và cập nhật hàng loạt mà không yêu cầu xây dựng một hệ thống xử lý dữ liệu phân tán riêng.
- Celery: Framework hàng đợi tác vụ cho Python, thường kết hợp với Redis hoặc RabbitMQ để phân phối công việc đến các worker. Celery phù hợp với những website cần chạy tác vụ nền, lập lịch và thử lại khi gặp lỗi.
- BullMQ: Thư viện hàng đợi tác vụ cho Node.js sử dụng Redis, hỗ trợ xử lý job, lập lịch, thử lại và quản lý trạng thái công việc. BullMQ phù hợp với ứng dụng web JavaScript cần xử lý nhiều tác vụ bất đồng bộ.
- Spring Batch: Framework thuộc hệ sinh thái Spring, được thiết kế cho các quy trình xử lý dữ liệu theo lô với khả năng quản lý job, step, giao dịch, trạng thái và phục hồi. Spring Batch thường được sử dụng trong các hệ thống Java có quy trình ETL hoặc xử lý dữ liệu nghiệp vụ phức tạp.
Các công cụ này thường phù hợp khi bạn muốn tách công việc nặng khỏi luồng xử lý yêu cầu web, đồng thời quản lý trạng thái và mở rộng số lượng worker theo nhu cầu. Việc lựa chọn nên dựa trên công nghệ hiện có của dự án và yêu cầu vận hành thay vì chỉ so sánh số lượng tính năng.
2. Công cụ tính toán phân tán cho dữ liệu lớn
Khi dữ liệu vượt quá khả năng xử lý hiệu quả của một máy chủ, các framework tính toán phân tán giúp chia công việc thành nhiều phần và thực thi trên một cụm máy. Nhóm công cụ này phù hợp với ETL, phân tích dữ liệu quy mô lớn và các quy trình cần tổng hợp nhiều nguồn thông tin.
- Apache Spark: Công cụ xử lý dữ liệu phân tán hỗ trợ các tác vụ batch, SQL, phân tích dữ liệu và xử lý luồng. Spark thường được lựa chọn khi cần xử lý khối lượng dữ liệu lớn bằng các phép biến đổi và tổng hợp phức tạp.
- Apache Hadoop: Hệ sinh thái hỗ trợ lưu trữ và xử lý dữ liệu phân tán, trong đó HDFS đảm nhiệm lưu trữ và MapReduce cung cấp mô hình tính toán theo lô. Hadoop phù hợp với một số hệ thống dữ liệu lớn cần khả năng phân phối công việc trên nhiều máy.
- Apache Beam: Mô hình lập trình thống nhất cho cả xử lý batch và stream, cho phép xây dựng pipeline dữ liệu có thể chạy trên các runner được hỗ trợ.
Các framework phân tán đem lại khả năng mở rộng đáng kể nhưng cũng làm tăng yêu cầu về hạ tầng, giám sát và vận hành. Với website chỉ cần cập nhật dữ liệu vài nghìn bản ghi hoặc gửi email theo lịch, một hệ thống worker đơn giản có thể đáp ứng tốt hơn về chi phí và mức độ phức tạp.
3. Nền tảng điều phối và lập lịch luồng công việc
Nhóm công cụ điều phối giúp quản lý mối quan hệ phụ thuộc giữa các tác vụ, thiết lập lịch chạy và theo dõi tiến trình của một quy trình gồm nhiều bước. Đây là lựa chọn phù hợp khi batch job cần thực hiện theo trình tự, sử dụng nhiều nguồn dữ liệu hoặc phối hợp giữa các dịch vụ.
- Apache Airflow: Nền tảng điều phối quy trình làm việc bằng DAG, hỗ trợ lập lịch, xác định quan hệ phụ thuộc, theo dõi trạng thái và chạy lại tác vụ thất bại. Airflow thường được sử dụng trong các pipeline ETL và quy trình dữ liệu định kỳ.
- Prefect: Công cụ điều phối workflow, giúp xây dựng, lập lịch và giám sát các quy trình dữ liệu bằng Python. Prefect phù hợp với nhóm kỹ thuật muốn quản lý trạng thái và khả năng phục hồi của pipeline.
- Kubernetes CronJob: Đây là cơ chế lập lịch công việc theo thời gian trong Kubernetes cho phép bạn khởi chạy các workload theo cấu hình định kỳ. Công cụ này phù hợp khi batch job được đóng gói thành container và cần chạy trong hạ tầng Kubernetes.
Bạn nên lựa chọn công cụ điều phối dựa trên số lượng job, mức độ phụ thuộc, yêu cầu theo dõi lịch sử và khả năng khôi phục. Với một tác vụ độc lập, bộ lập lịch đơn giản có thể đủ dùng; với pipeline nhiều bước, nền tảng điều phối chuyên dụng sẽ giúp kiểm soát luồng công việc rõ ràng hơn.
4. Dịch vụ hạ tầng đám mây quản lý toàn diện
Các nền tảng đám mây cung cấp dịch vụ chạy tác vụ theo lịch, xử lý dữ liệu phân tán và điều phối pipeline mà không yêu cầu doanh nghiệp tự quản lý toàn bộ máy chủ. Mô hình này phù hợp với website cần mở rộng linh hoạt theo khối lượng công việc và muốn giảm gánh nặng vận hành hạ tầng.
- AWS Batch: Dịch vụ quản lý và lập lịch công việc tính toán theo lô trên hạ tầng AWS, hỗ trợ phân bổ tài nguyên dựa trên yêu cầu của job.
- Google Cloud Dataflow: Dịch vụ xử lý dữ liệu được quản lý dựa trên Apache Beam, hỗ trợ pipeline batch và streaming.
- Azure Data Factory: Dịch vụ tích hợp và điều phối dữ liệu, hỗ trợ xây dựng pipeline để trích xuất, chuyển đổi và nạp dữ liệu giữa các hệ thống.
Khi sử dụng dịch vụ đám mây, bạn cần xem xét chi phí tính toán, lưu trữ, truyền dữ liệu, giới hạn tài nguyên và mức độ phụ thuộc vào nhà cung cấp. Với website có tải biến động, khả năng tự động mở rộng và theo dõi chi phí theo từng đợt xử lý là những yếu tố quan trọng khi lựa chọn nền tảng.
Nguyên tắc thiết kế hệ thống batch processing chịu lỗi tốt
Một hệ thống batch processing hiệu quả không chỉ cần xử lý nhanh mà còn phải đảm bảo dữ liệu chính xác, hạn chế tác vụ trùng lặp và có khả năng phục hồi khi xảy ra sự cố. Hiểu rõ batch là gì – một nhóm dữ liệu hoặc tác vụ được gom lại để xử lý cùng nhau sẽ giúp bạn thiết kế cơ chế kiểm soát phù hợp ngay từ đầu, đảm bảo hệ thống vận hành ổn định khi khối lượng dữ liệu tăng hoặc quy trình bị gián đoạn.
1. Đảm bảo tính bất biến (idempotency)
Idempotency là đặc tính cho phép thực hiện một thao tác nhiều lần nhưng vẫn tạo ra cùng một kết quả cuối cùng như khi thực hiện một lần. Đây là nguyên tắc quan trọng trong batch processing vì tác vụ có thể được chạy lại khi gặp lỗi, hết thời gian chờ hoặc không nhận được xác nhận hoàn thành từ hệ thống.
Thiết kế cơ chế idempotency ngay từ đầu giúp hệ thống có thể thử lại các tác vụ khi xảy ra lỗi mà không làm phát sinh những thay đổi dữ liệu ngoài ý muốn. Nhờ đó, hệ thống hạn chế tình trạng ghi nhận dữ liệu trùng lặp, đảm bảo tính nhất quán và đơn giản hóa quá trình khôi phục sau sự cố.
2. Kỹ thuật chia khối (chunking) và phân trang (paging)
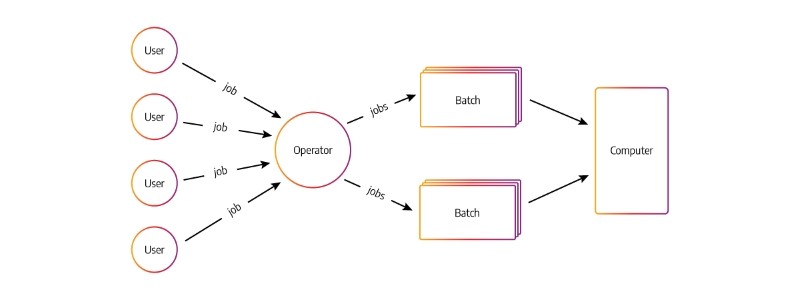
Khi phải xử lý hàng nghìn hoặc hàng triệu bản ghi, việc tải toàn bộ dữ liệu vào bộ nhớ có thể khiến hệ thống tiêu tốn nhiều tài nguyên, kéo dài thời gian thực thi hoặc gặp lỗi do vượt giới hạn bộ nhớ. Chunking và paging giúp chia dữ liệu thành các phần nhỏ để xử lý lần lượt hoặc theo từng nhóm.
- Chunking: Chia tập dữ liệu thành các lô có kích thước xác định, chẳng hạn 500 hoặc 1.000 bản ghi mỗi lô. Kích thước phù hợp phụ thuộc vào dung lượng dữ liệu, năng lực máy chủ và thời gian xử lý từng bản ghi.
- Paging: Truy xuất dữ liệu theo từng trang thay vì tải toàn bộ kết quả cùng lúc. Với tập dữ liệu lớn hoặc thường xuyên thay đổi, phân trang theo khóa (keyset pagination) thường ổn định hơn phân trang bằng OFFSET lớn.
3. Xử lý lỗi linh hoạt (checkpointing, retry logic & dead-letter queue)
Batch processing tools cần có cơ chế xử lý lỗi để tránh phải chạy lại toàn bộ quy trình khi chỉ một phần dữ liệu gặp sự cố. Ba kỹ thuật thường được sử dụng gồm checkpointing, retry logic và dead-letter queue.
- Checkpointing: Lưu lại trạng thái hoặc vị trí xử lý gần nhất để hệ thống tiếp tục từ điểm đã hoàn thành sau khi bị gián đoạn, thay vì bắt đầu lại từ đầu.
- Retry logic: Tự động thử lại những tác vụ thất bại do lỗi tạm thời như mất kết nối hoặc dịch vụ phản hồi chậm. Nên giới hạn số lần thử và áp dụng khoảng nghỉ tăng dần (exponential backoff) để tránh tạo thêm áp lực lên hệ thống đang gặp sự cố.
- Dead-letter queue (DLQ): Chuyển các tác vụ vẫn thất bại sau số lần thử cho phép sang một hàng đợi riêng để kiểm tra, ghi nhận nguyên nhân và xử lý thủ công hoặc lên lịch chạy lại.
Chẳng hạn, nếu quy trình gửi email marketing bị gián đoạn khi đã xử lý 70% danh sách, checkpointing giúp xác định phần công việc đã hoàn thành. Những email gặp lỗi tạm thời có thể được thử lại, còn các trường hợp thất bại kéo dài được đưa vào DLQ để kiểm tra. Khi kết hợp với idempotency, những cơ chế này giúp hạn chế bỏ sót dữ liệu và tránh xử lý trùng khi khôi phục tác vụ.
4. Phân bổ thời gian thực thi (off-peak scheduling) và kiểm soát tốc độ (throttling)
Off-peak scheduling là cách lên lịch chạy các tác vụ nặng vào thời điểm lượng truy cập thấp, chẳng hạn tổng hợp báo cáo vào ban đêm hoặc đồng bộ dữ liệu ngoài giờ cao điểm. Trong khi đó, throttling giới hạn số lượng tác vụ, yêu cầu hoặc bản ghi được xử lý trong một khoảng thời gian nhất định.
Các tác vụ batch có thể tiêu tốn đáng kể CPU, bộ nhớ, băng thông hoặc tài nguyên cơ sở dữ liệu. Vì vậy, cần lựa chọn thời điểm thực thi và giới hạn tốc độ xử lý phù hợp để tránh ảnh hưởng đến hoạt động chính của website. Việc kết hợp hai phương pháp giúp phân bổ tài nguyên hợp lý, duy trì khả năng phản hồi của website và giảm nguy cơ tác vụ nền cạnh tranh tài nguyên với các yêu cầu trực tiếp từ người dùng.
5. Giám sát toàn diện (monitoring, alerting & metrics)
Giám sát giúp đội ngũ vận hành theo dõi tình trạng thực thi batch processing, phát hiện sớm sự cố và đánh giá hiệu suất theo thời gian. Thay vì chỉ kiểm tra tác vụ có hoàn thành hay không, cần thu thập các chỉ số phản ánh cả tiến độ, chất lượng dữ liệu và mức sử dụng tài nguyên. Một số chỉ số quan trọng cần theo dõi gồm:
- Thời gian xử lý: Thời gian bắt đầu, kết thúc và tổng thời gian hoàn thành mỗi đợt batch.
- Số lượng bản ghi: Tổng dữ liệu cần xử lý, số bản ghi thành công, thất bại hoặc bị bỏ qua.
- Tỷ lệ lỗi và số lần thử lại: Giúp nhận diện những tác vụ thường xuyên gặp sự cố hoặc nguồn dữ liệu không ổn định.
- Độ trễ xử lý: Khoảng thời gian từ khi dữ liệu phát sinh đến khi được xử lý xong.
- Tài nguyên hệ thống: Mức sử dụng CPU, bộ nhớ, dung lượng hàng đợi và tải cơ sở dữ liệu.
Bên cạnh đó, cần thiết lập cơ chế cảnh báo khi tác vụ vượt quá thời gian xử lý dự kiến, hàng đợi tăng đột biến, tỷ lệ lỗi vượt ngưỡng cho phép hoặc dữ liệu không được cập nhật đúng lịch. Đồng thời, nhật ký thực thi nên ghi lại mã định danh của từng tác vụ và thông tin lỗi chi tiết, giúp quá trình theo dõi, truy vết nguyên nhân và khắc phục sự cố diễn ra nhanh chóng, hiệu quả hơn.
Nhìn chung, batch processing là giải pháp xử lý dữ liệu theo lô, giúp website tối ưu các tác vụ khối lượng lớn như cập nhật cơ sở dữ liệu, tổng hợp báo cáo, gửi email và đồng bộ dữ liệu vào data warehouse. Qua bài viết, Phương Nam Vina giúp bạn hiểu rõ cơ chế hoạt động, các công cụ phổ biến và nguyên tắc thiết kế hệ thống chịu lỗi, từ đó lựa chọn phương pháp phù hợp với nhu cầu thực tế. Việc kết hợp xử lý theo lô với giám sát và kiểm soát dữ liệu chặt chẽ sẽ góp phần tối ưu tài nguyên, đảm bảo website vận hành ổn định và dễ dàng mở rộng trong tương lai.
Tham khảo thêm:
 Clean Architecture là gì? Cấu trúc và quy trình triển khai
Datetime là gì? Cách xử lý ngày giờ trong phát triển website
Usability testing là gì? Phương pháp và quy trình usability testing